⌘CtrlK
Appearance
在配置数据集成同步任务前,用户需要配置好数据同步的源端和目标端数据库相关信息,以便在配置同步任务时,可以通过选择数据源名称来确定同步任务读取和写入的数据库。
当前版本支持的数据源,包括:关系数据库、大数据、文件/对象、NoSQL、消息队列、ERP。
数据源管理的功能包括:
| 类型 | 版本 |
|---|---|
| ArgoDB | 6.0.3 |
| AnalyticDB MySQL | 3.0 |
| AnalyticDB PostgreSQL | 6.0 |
| Clickhouse | 22.1.3.7 |
| Doris | 3.0.3 |
| DM(达梦) | DM8 |
| Elasticsearch | 8.1.2 |
| GBase8a(南大通用 ) | 8.3.81.51 |
| GBase8s(南大通用 ) | 8.3.81.51 |
| HBase | 2.1.0-cdh6.3.2、1.2.0-cdh5.15.2 |
| HDFS | Hadoop 3.0.0-cdh6.3.2、Hadoop 2.6.0-cdh5.15.2 |
| Hive | 2.1.1-cdh6.3.2、1.1.0-cdh5.15.2、4.0 |
| HighGo(瀚高) | 5 |
| Hyperbase | 9.0 |
| IBM DB2 | 9.7 |
| Inceptor | 3.1.4 |
| Kafka | 2.13-2.8.2 |
| KingBaseES(人大金仓) | V8R3、V8R6 |
| MariaDB | 3.5.1 |
| MaxCompute | 3.9.0 |
| MinIO | 8.5.17 |
| MongoDB | 4.2.5 |
| MySQL | 5.7.25、8.0.28 |
| Neo4j | 4.3.6 |
| OceanBase | 4.3.4 |
| openGauss | 2.1.0 |
| Oracle | 12c、19c |
| Oscar(神通) | 7.0.8 |
| PostgreSQL | 9.6.2、10.23 |
| RabbitMQ | 3.8.9 |
| Redis | 3.8.0 |
| RocketMQ | 4.9.4 |
| S3 | 2.31.57 |
| SAP HANA | 2.23.10 |
| SAP | ecc6.0 |
| SQL Server | 2012、2016 |
| StarRocks | 3.0.3 |
| TDSQL(PostgreSQL模式) | 42.3.4 |
| TiDB | 8.0.20 |
| UXDB(优炫) | 2.1 |
| Vastbase(海量) | 42.3.4 |
| XuguDB(虚谷) | 12.0.0 |
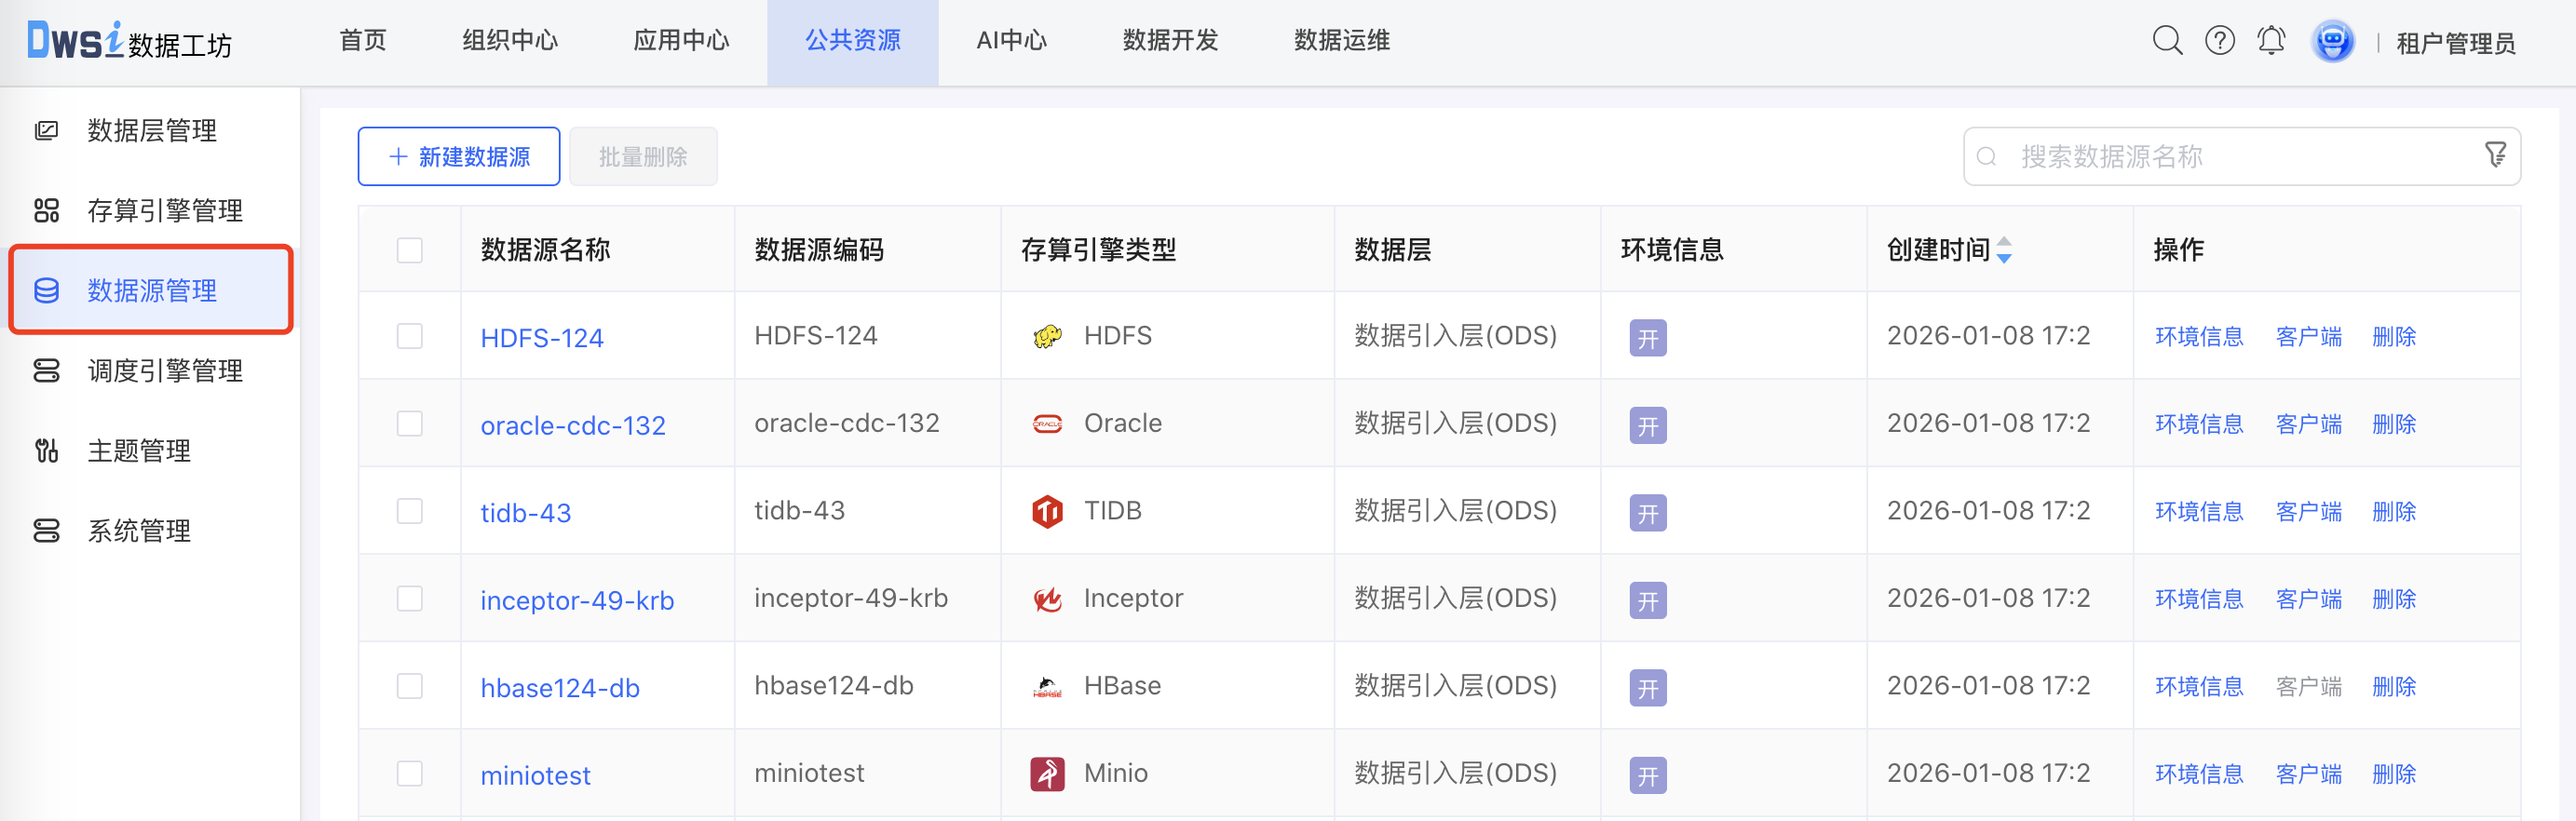
点击菜单栏“公共资源”,进入公共资源管理界面,再点击左侧菜单的"数据源管理",进入数据源管理界面。
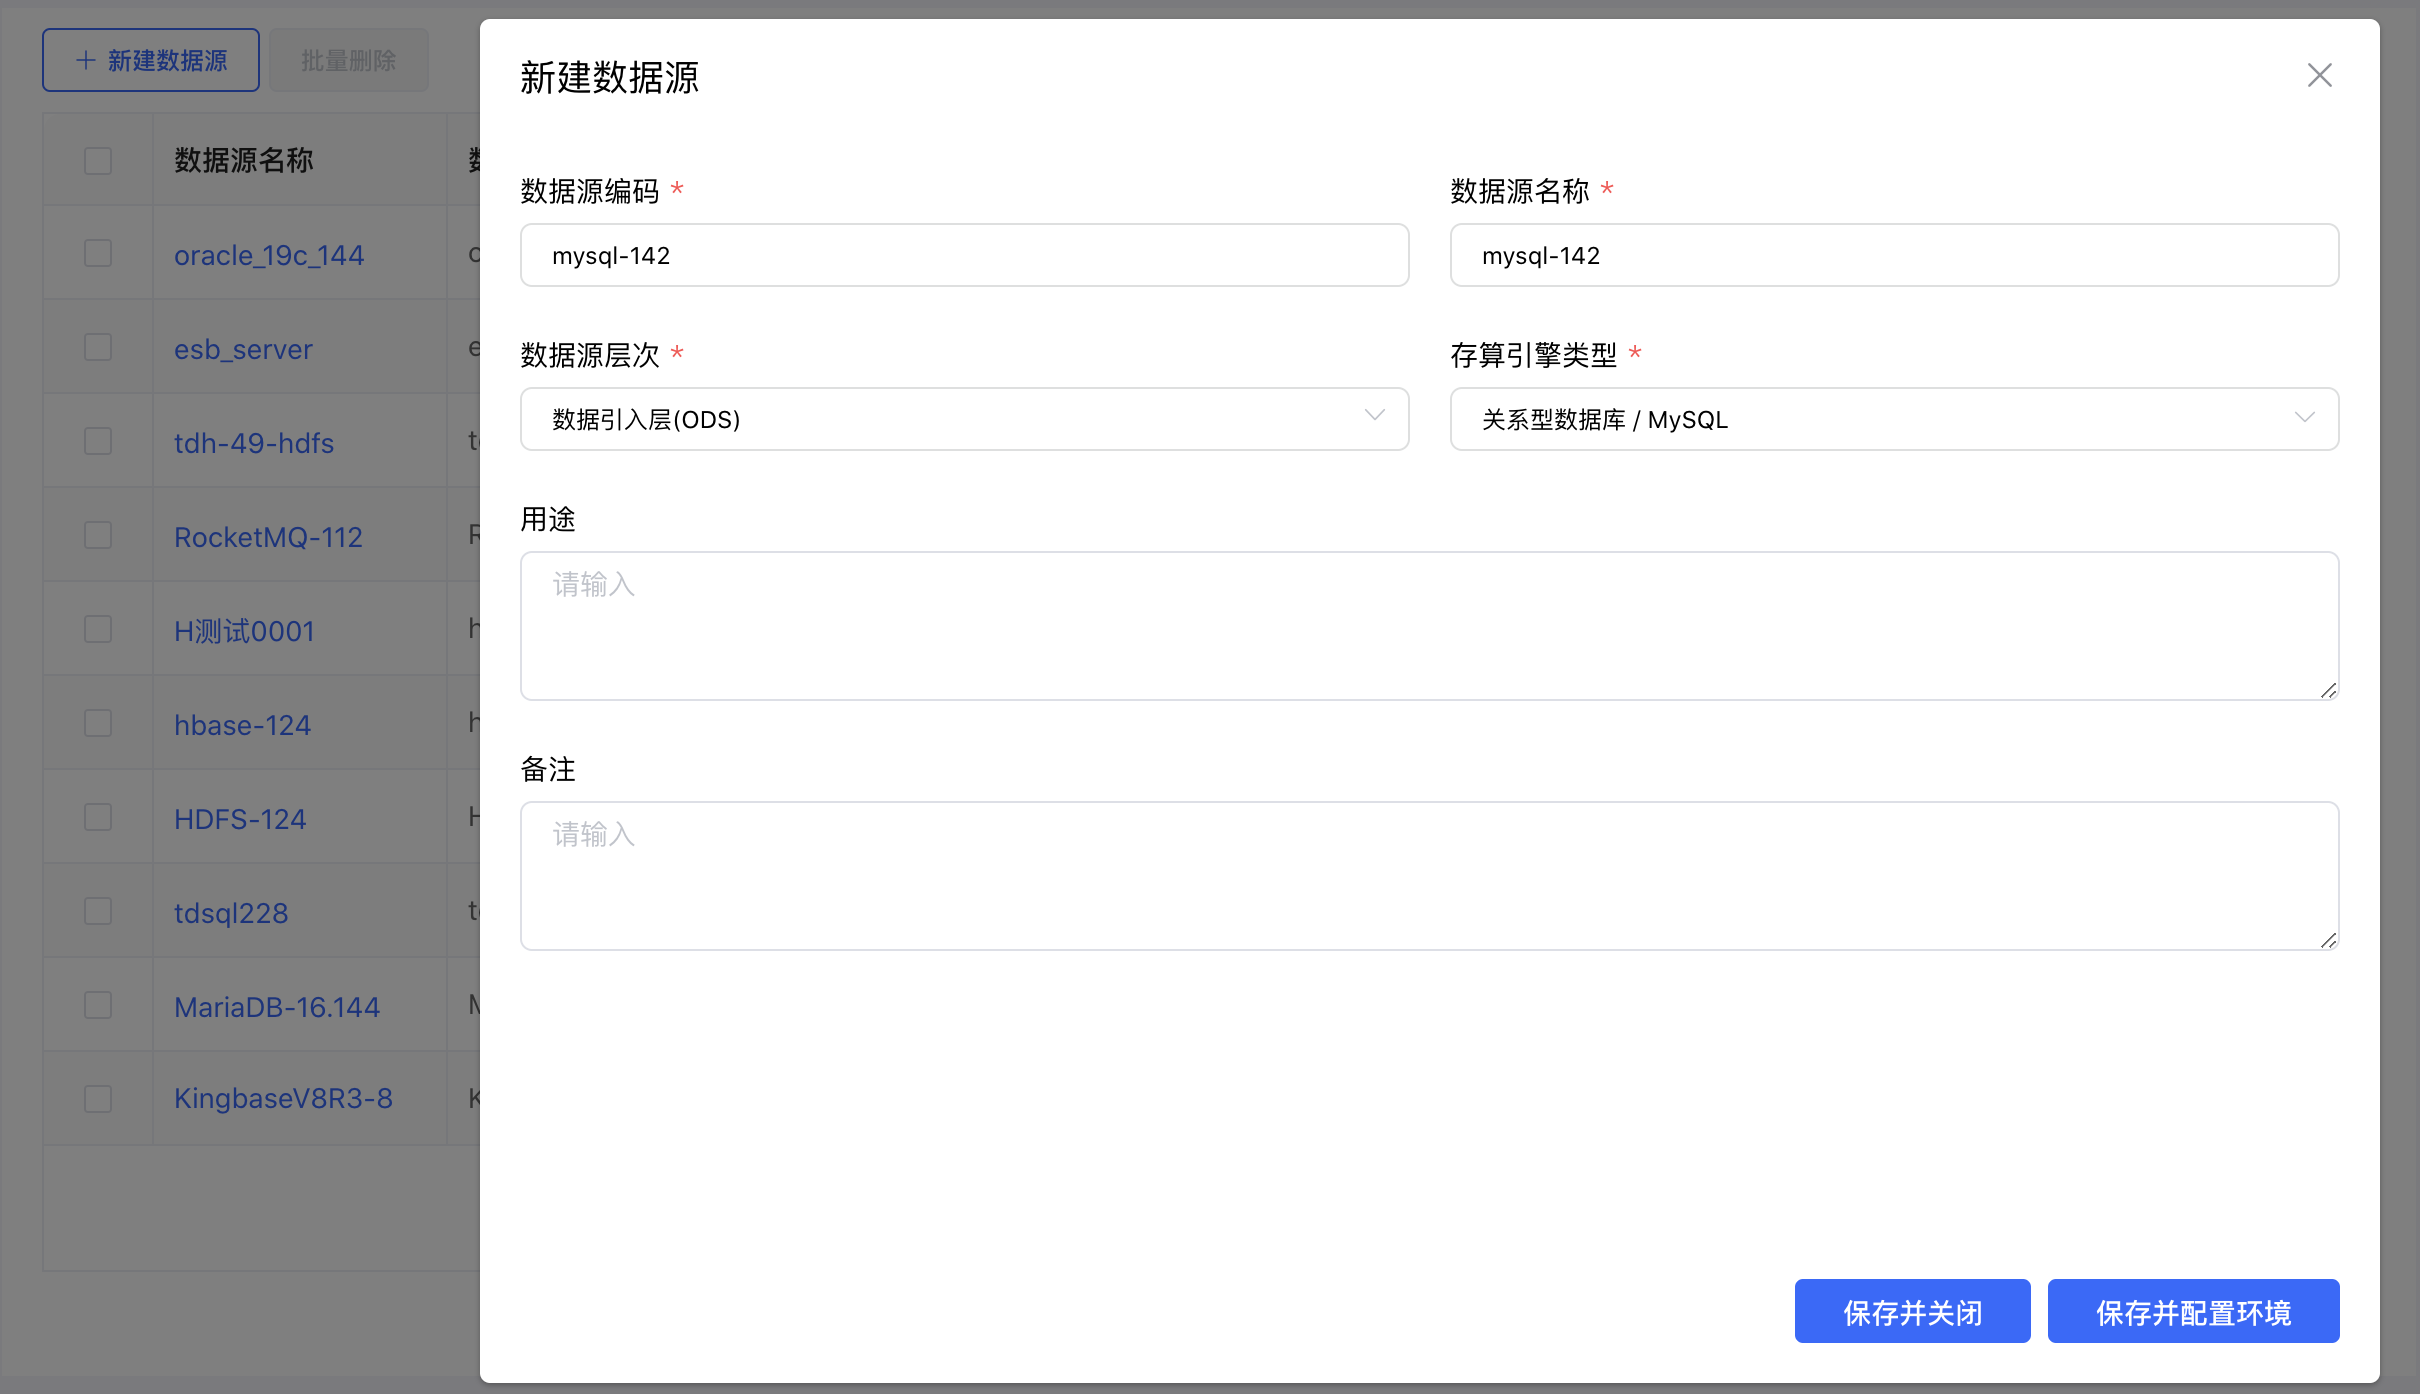
点击【新建数据源】按钮,弹出"创建数据源"的弹窗,按照界面要求录入数据源参数。
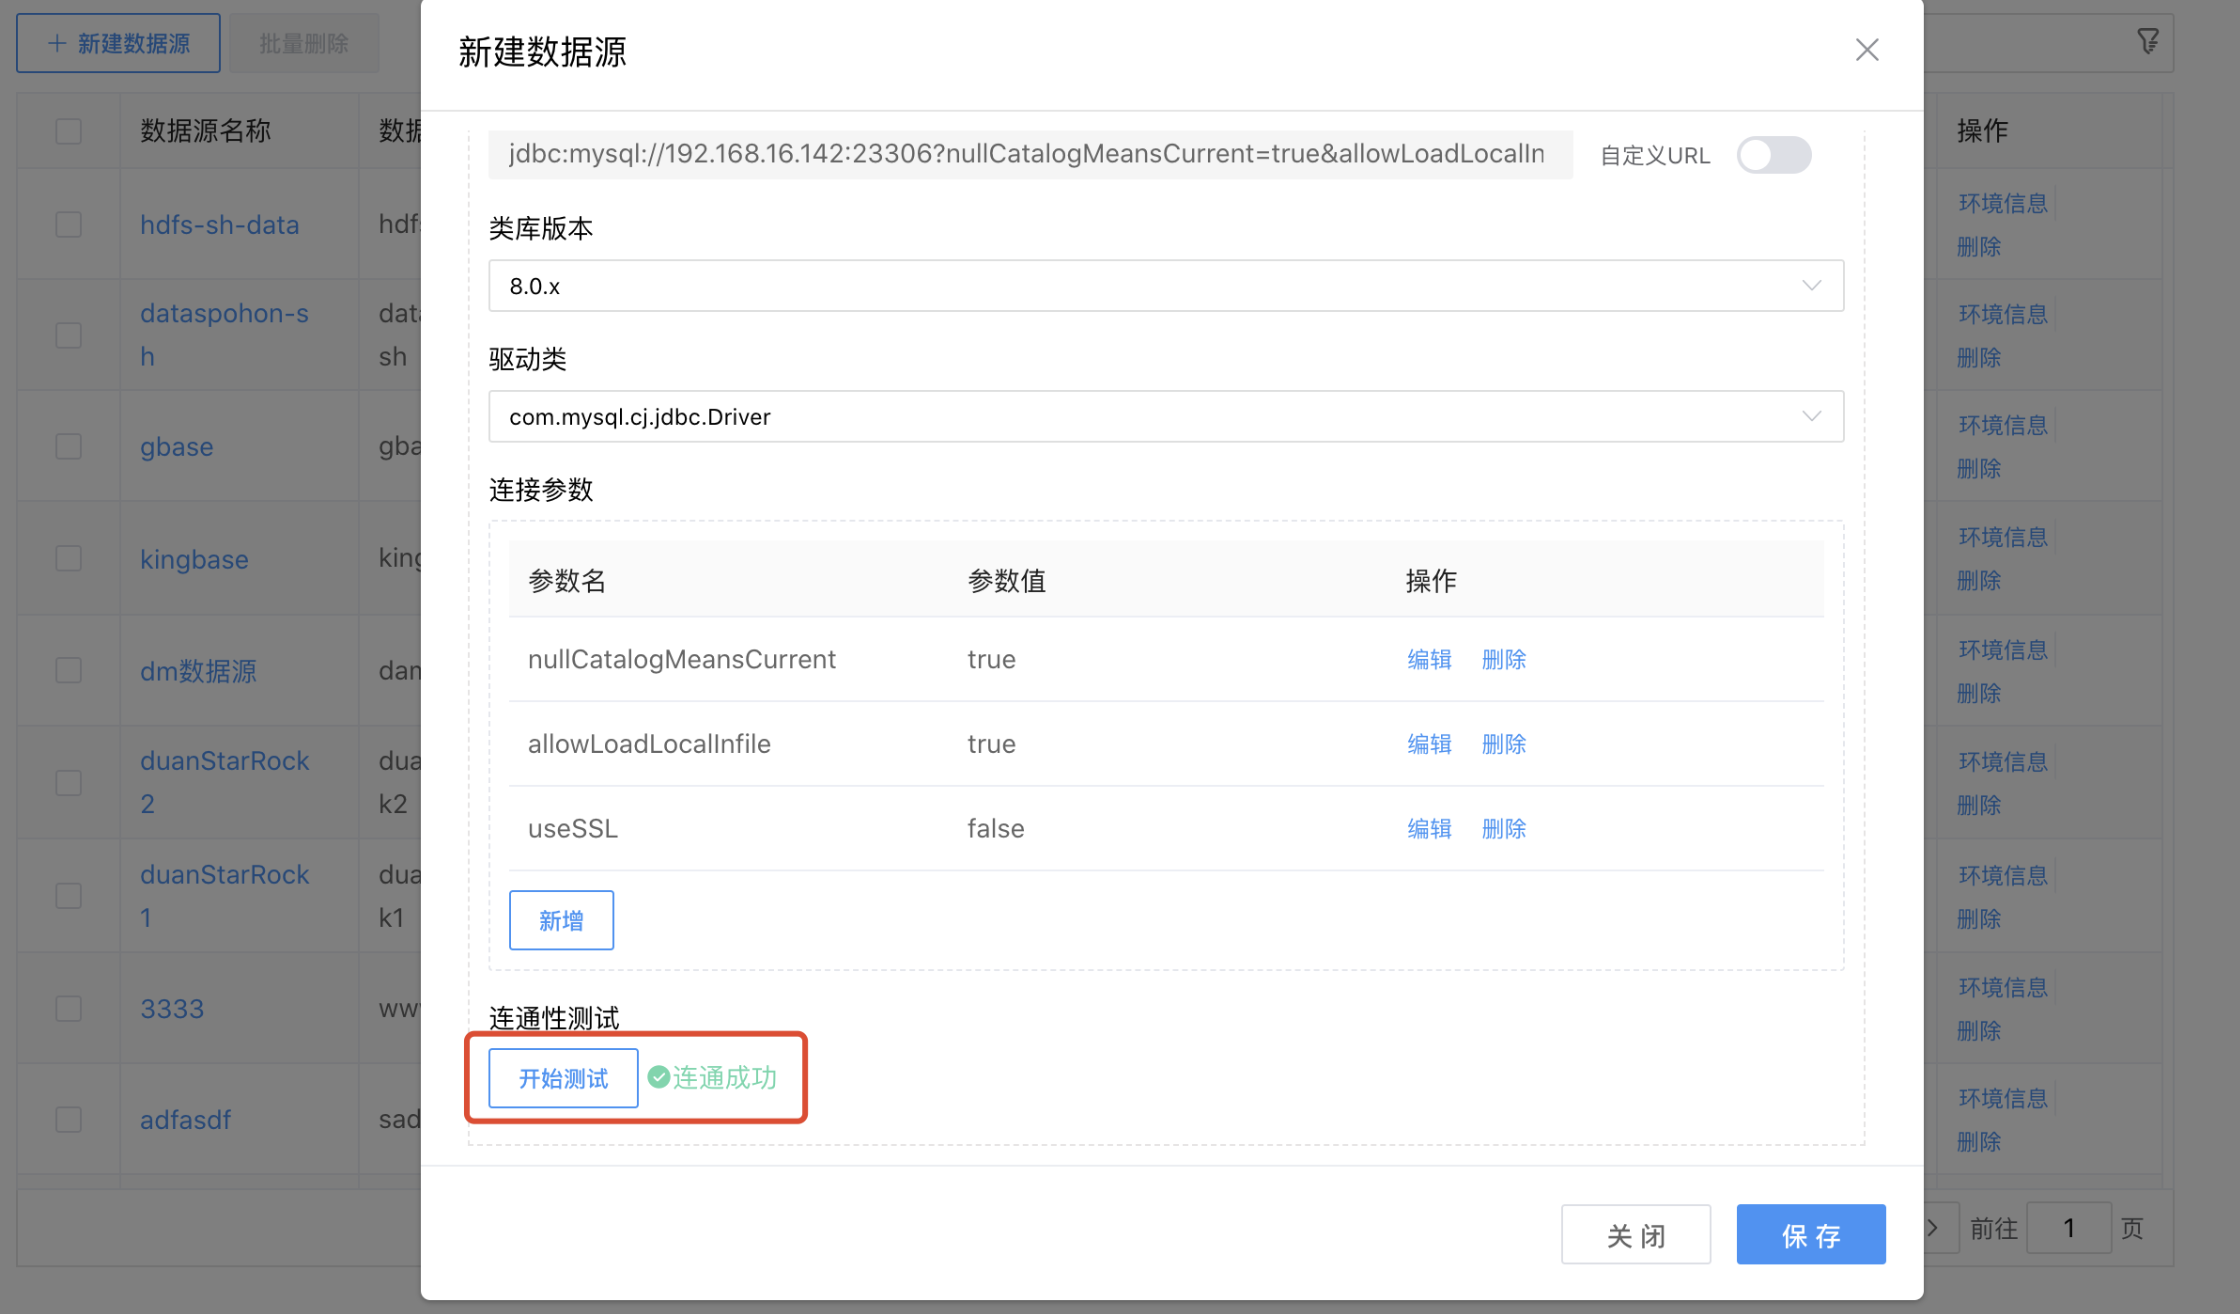
为确保数据源的可用性,可以点击【开始测试】按钮进行连通性测试。
点击【保存并关闭】按钮,保存新建的数据源信息。
点击【保存并配置环境】按钮,跳转到数据源环境配置页面,按照页面要求继续录入数据源多个环境(如:开发环境、生产环境)的配置参数。
新建数据源配置项说明:
| 配置项 | 描述 |
|---|---|
| 数据源编码 | 当前创建的数据源编码,由用户自定义且不可为空,不少于3个字符。命名可包含字母、数字、下划线、中划线。 |
| 数据源名称 | 当前创建的数据源名称,由用户自定义且不可为空,不少于3个字符。命名可包含汉字、字母、数字、下划线、中划线。 |
| 数据源层次 | 当前创建的数据源所属数据层,从下拉选项选择且不可为空。一个数据源只能隶属一个数据层。 |
| 存算引擎类型 | 数据源对应的存算引擎类型。 |
| 用途 | 当前创建的数据源的用途。 |
| 备注 | 当前创建的数据源的备注信息,用于记录用户自定义内容。 |
点击数据源列表上的"数据源名称",弹出"数据源详情"弹窗,用户可以根据需求进行参数的修改。
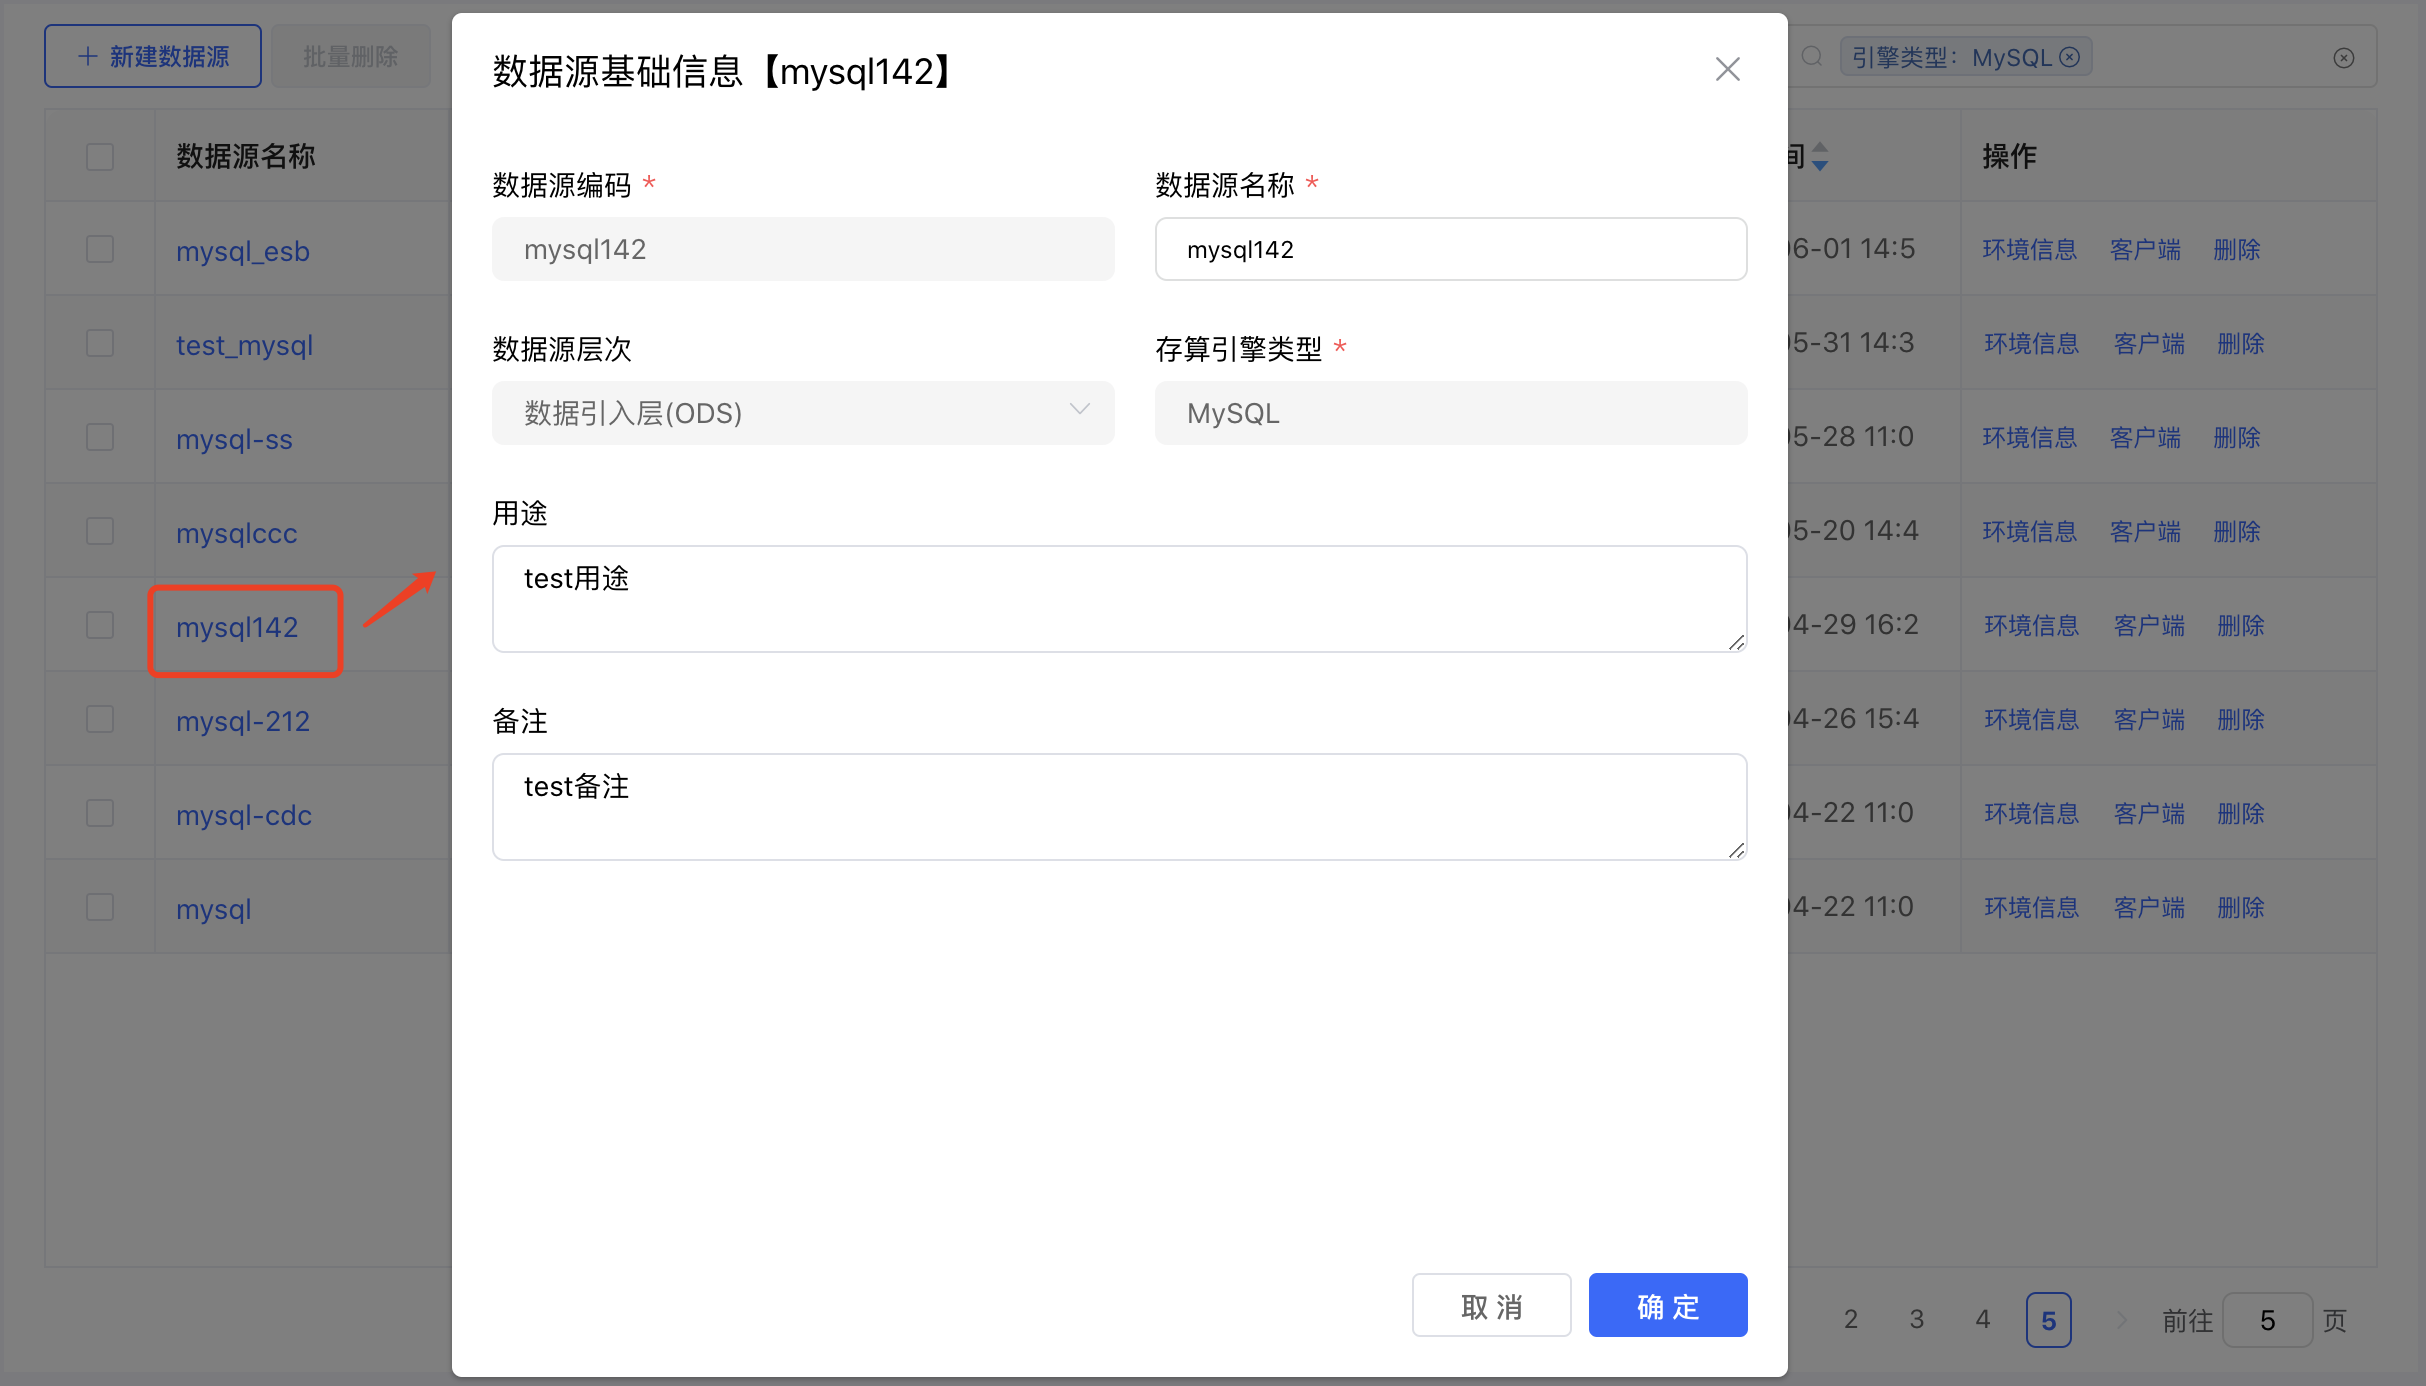
点击【确定】按钮,完成参数的修改、保存。
点击【取消】按钮,取消本次修改操作。
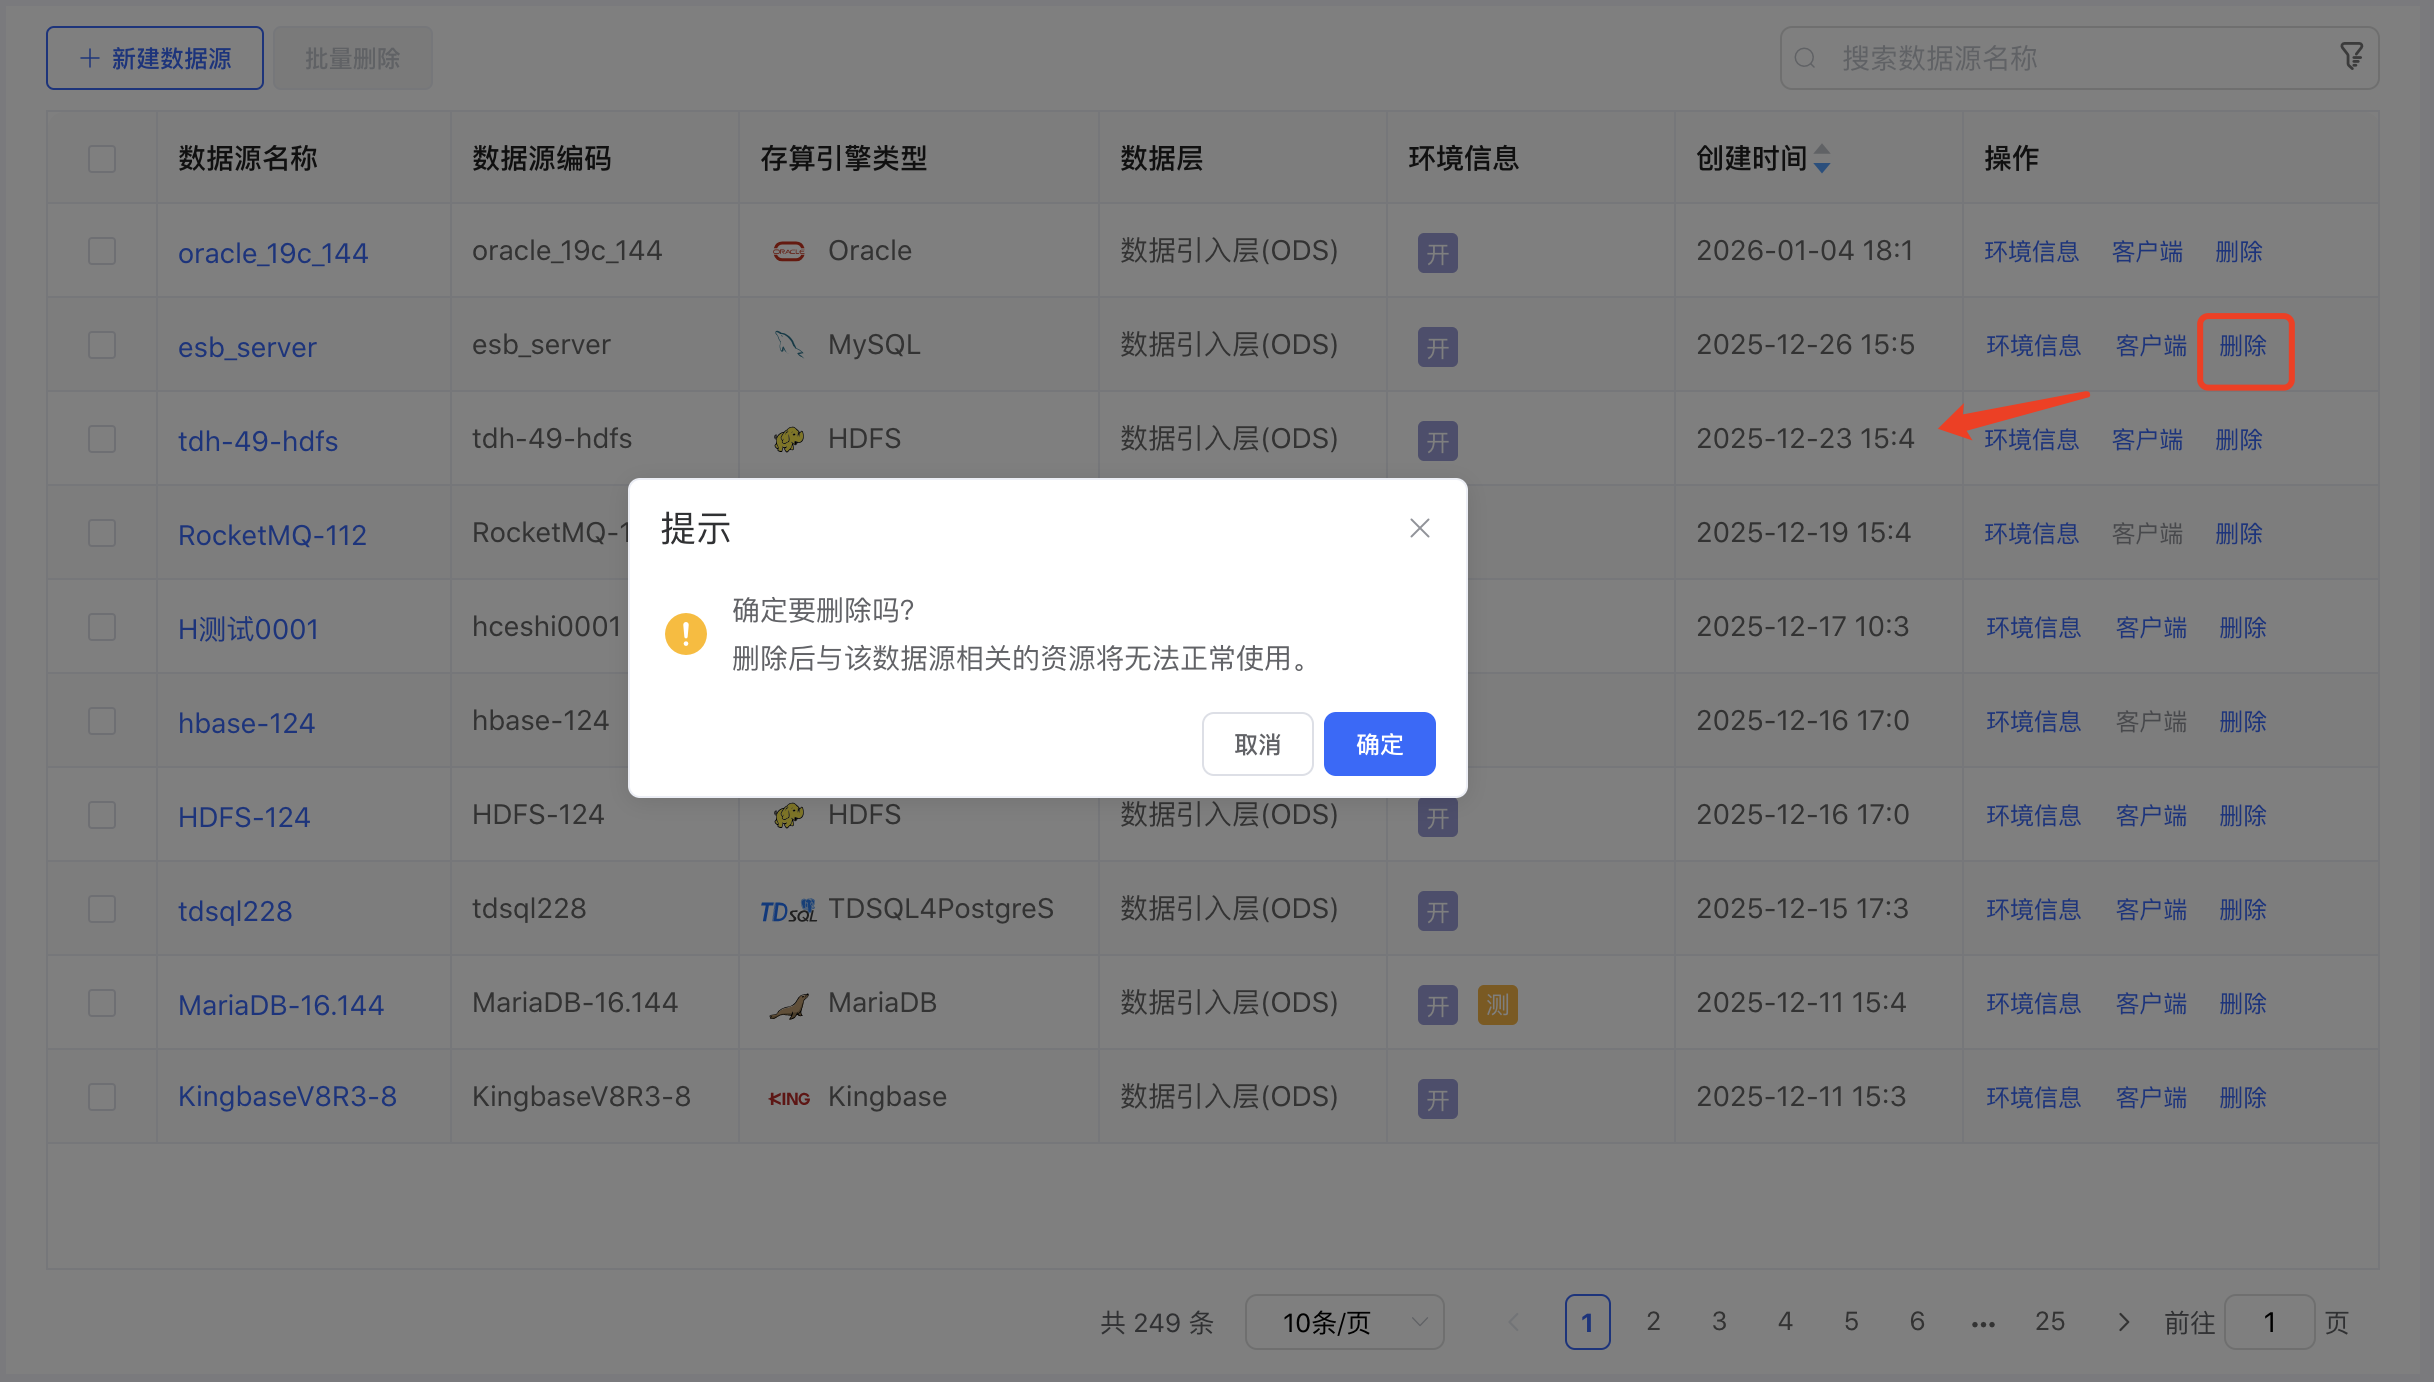
点击数据源列表后边的【删除】按钮,弹出"删除确认"弹框。
点击弹框的【确认】按钮,完成删除操作。
点击弹框的【取消】按钮,取消本次删除操作。
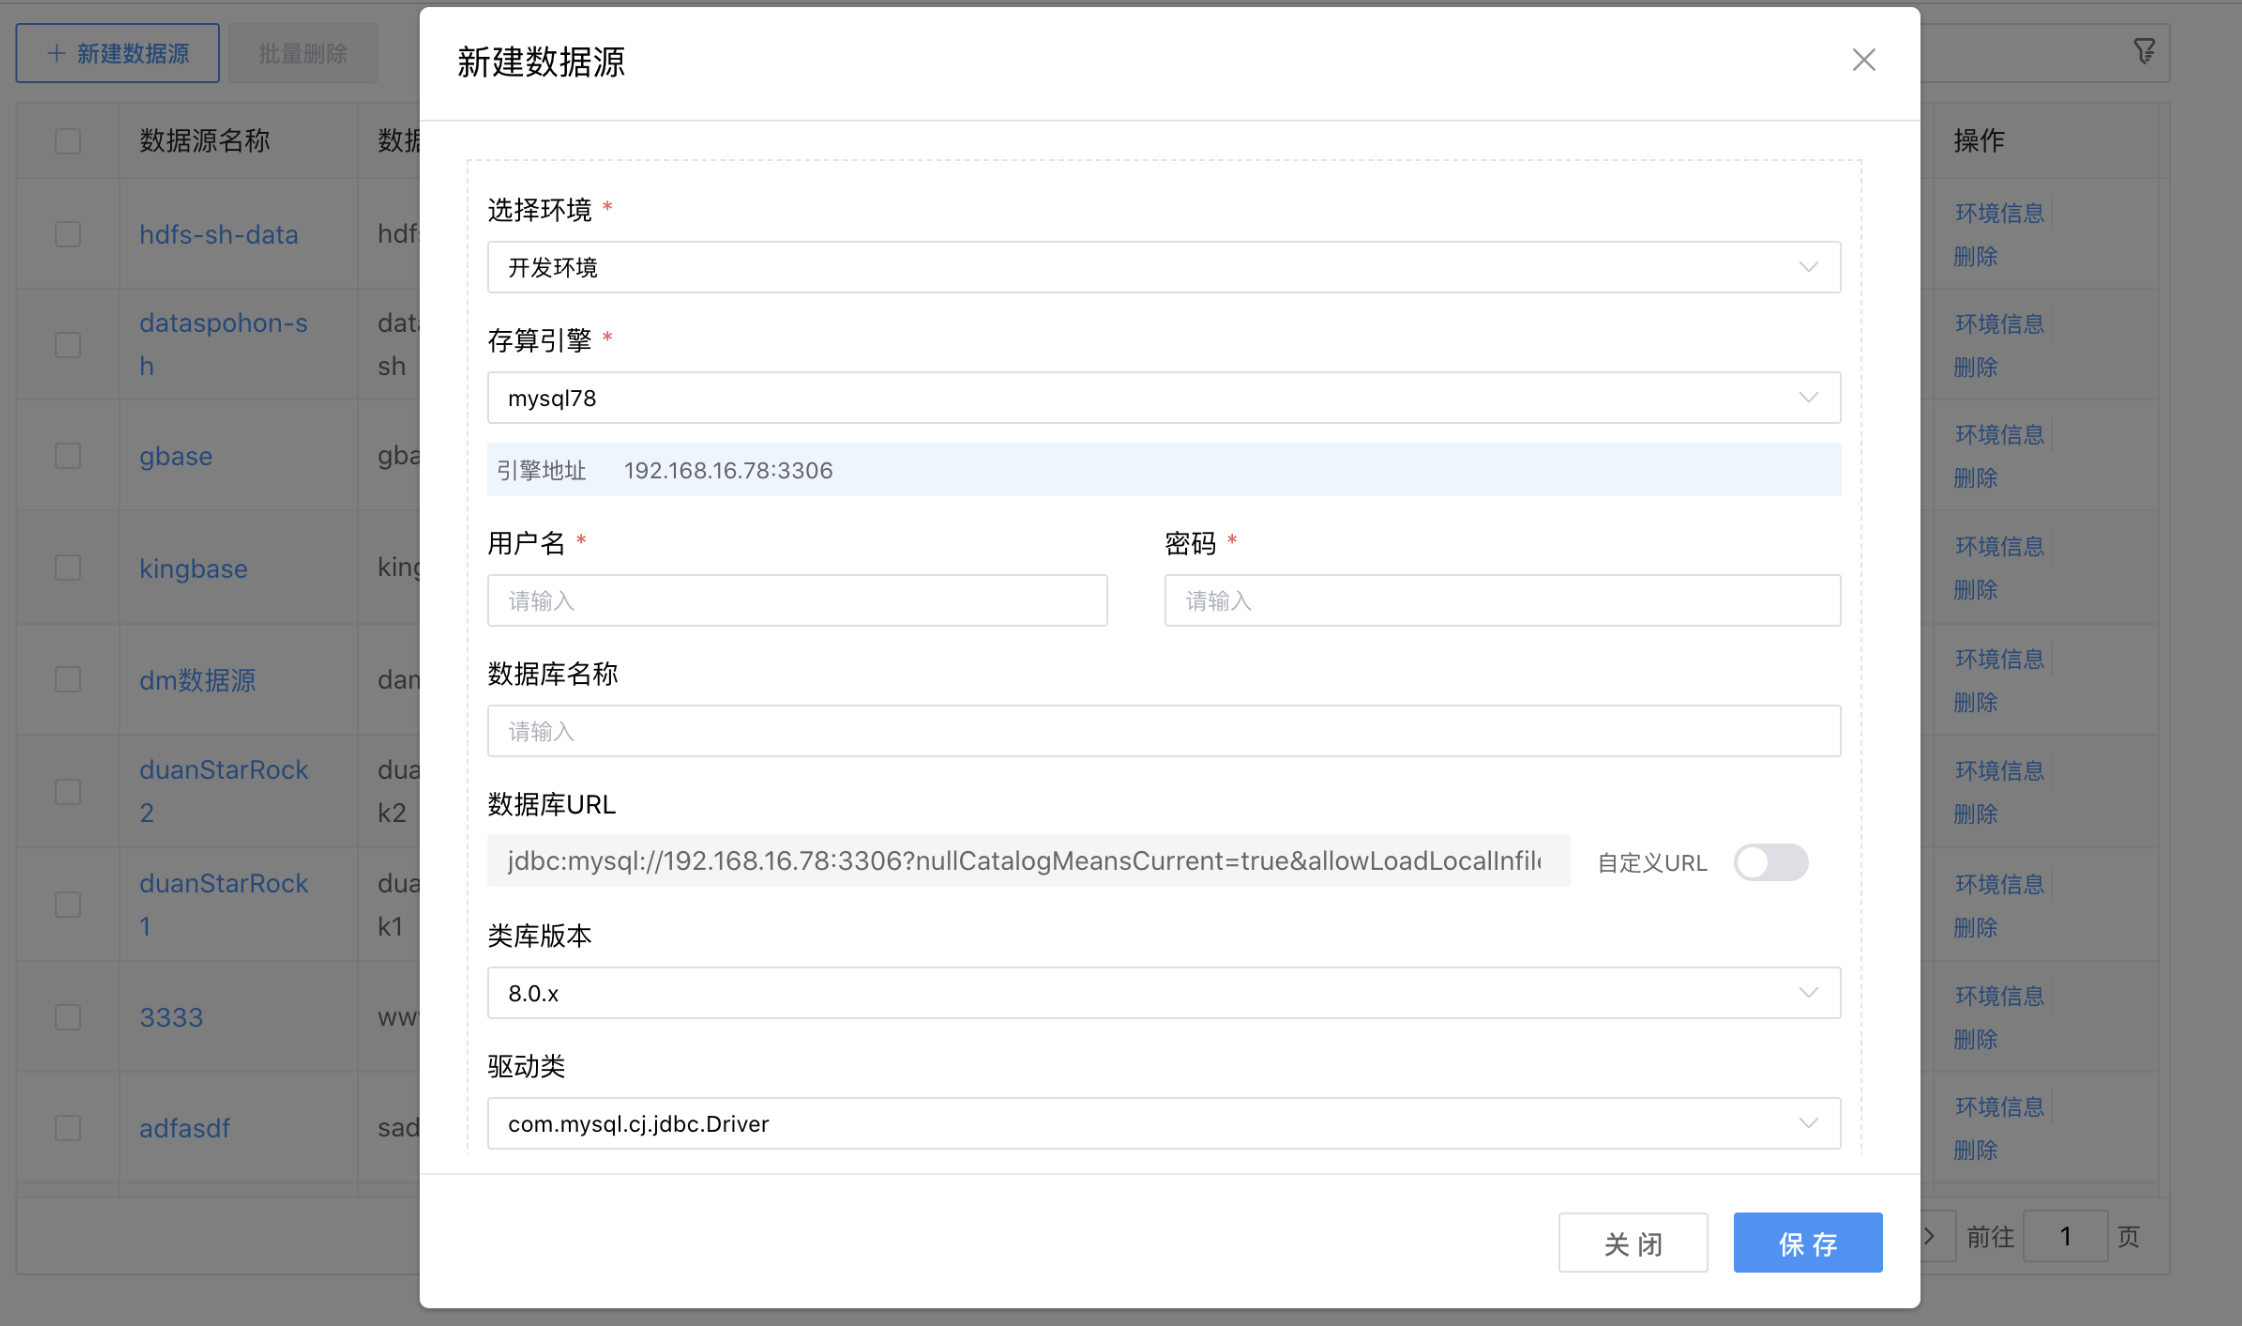
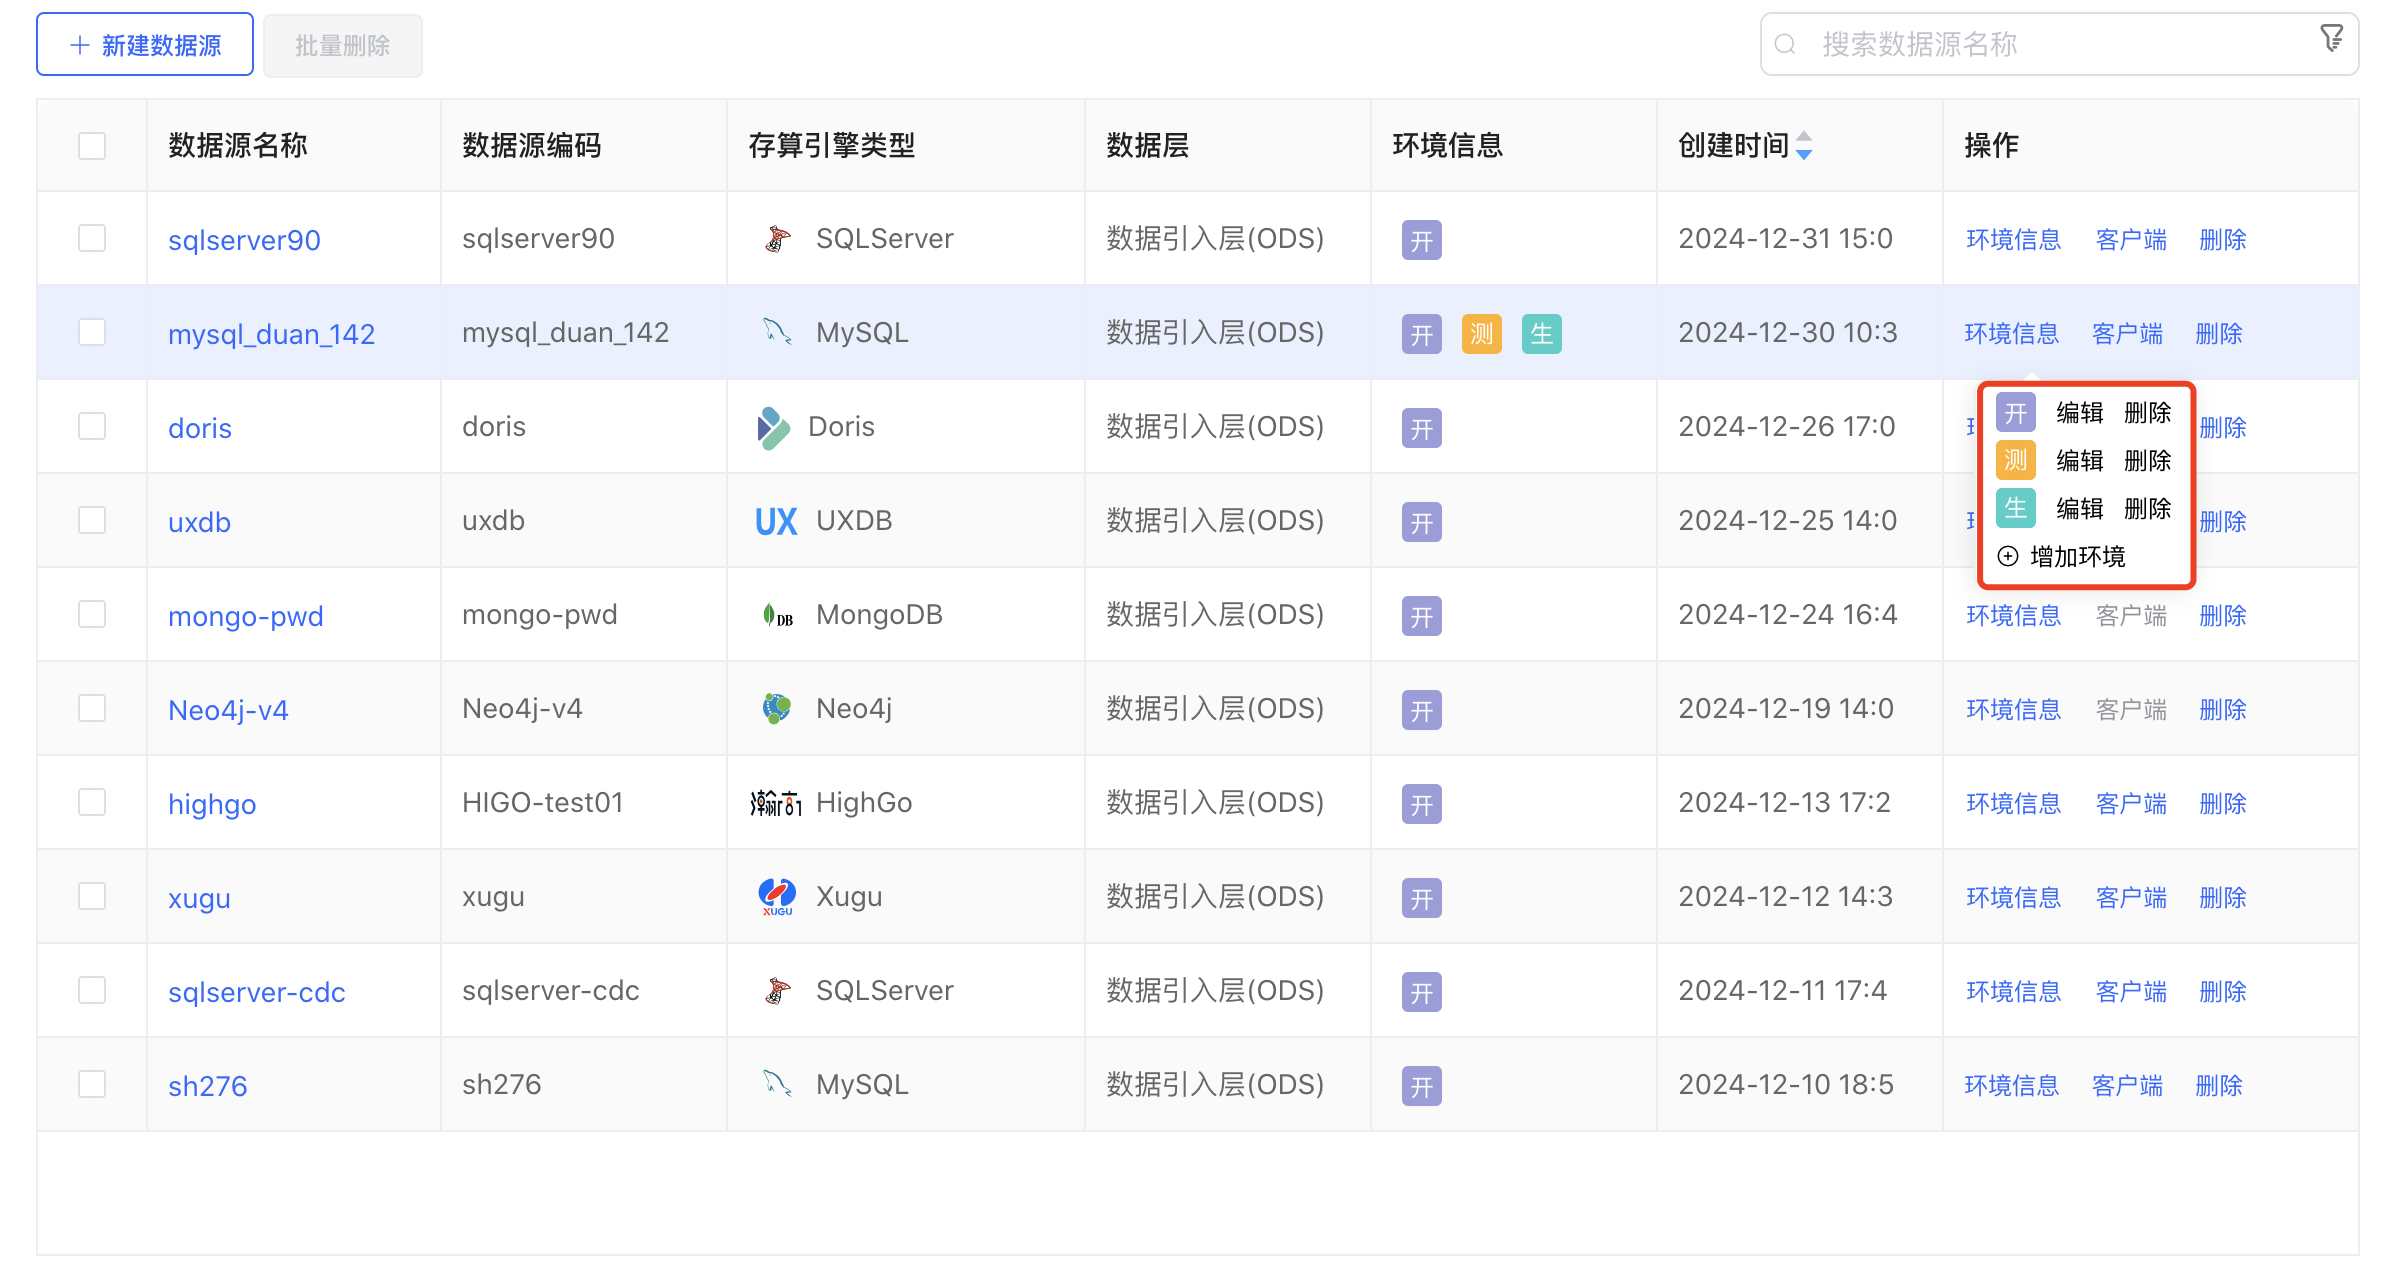
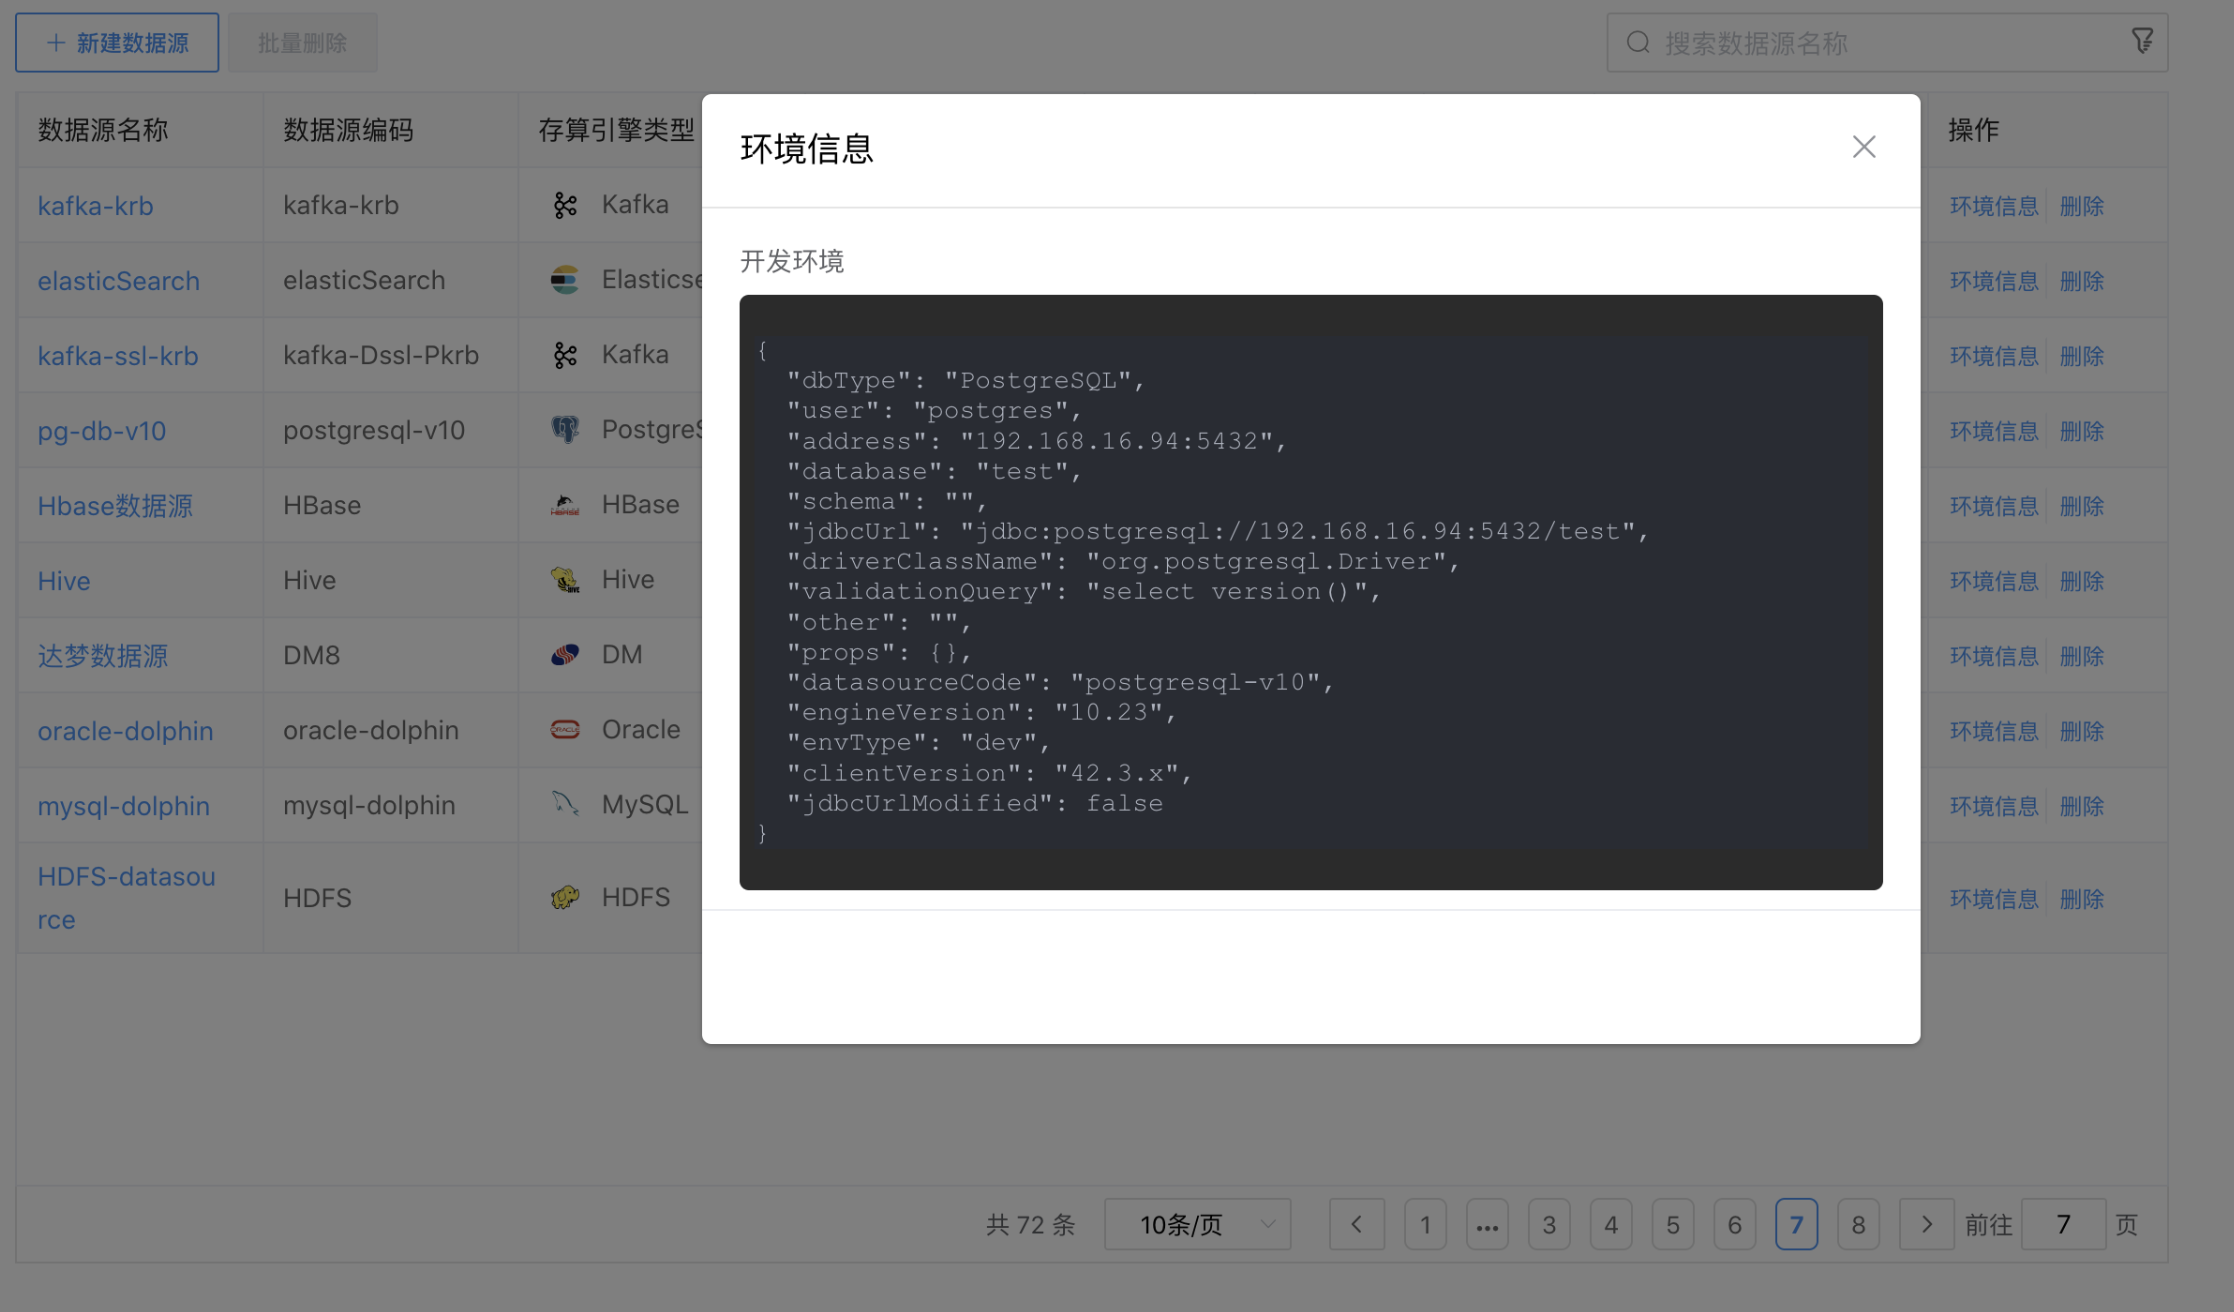
点击数据源列表后边的【环境信息】按钮,弹出"+增加环境"菜单,可以创建、维护各个环境(开发环境、生产环境……)的数据源连接配置信息。
点击【+增加环境】,可以创建新的数据源环境连接配置参数。
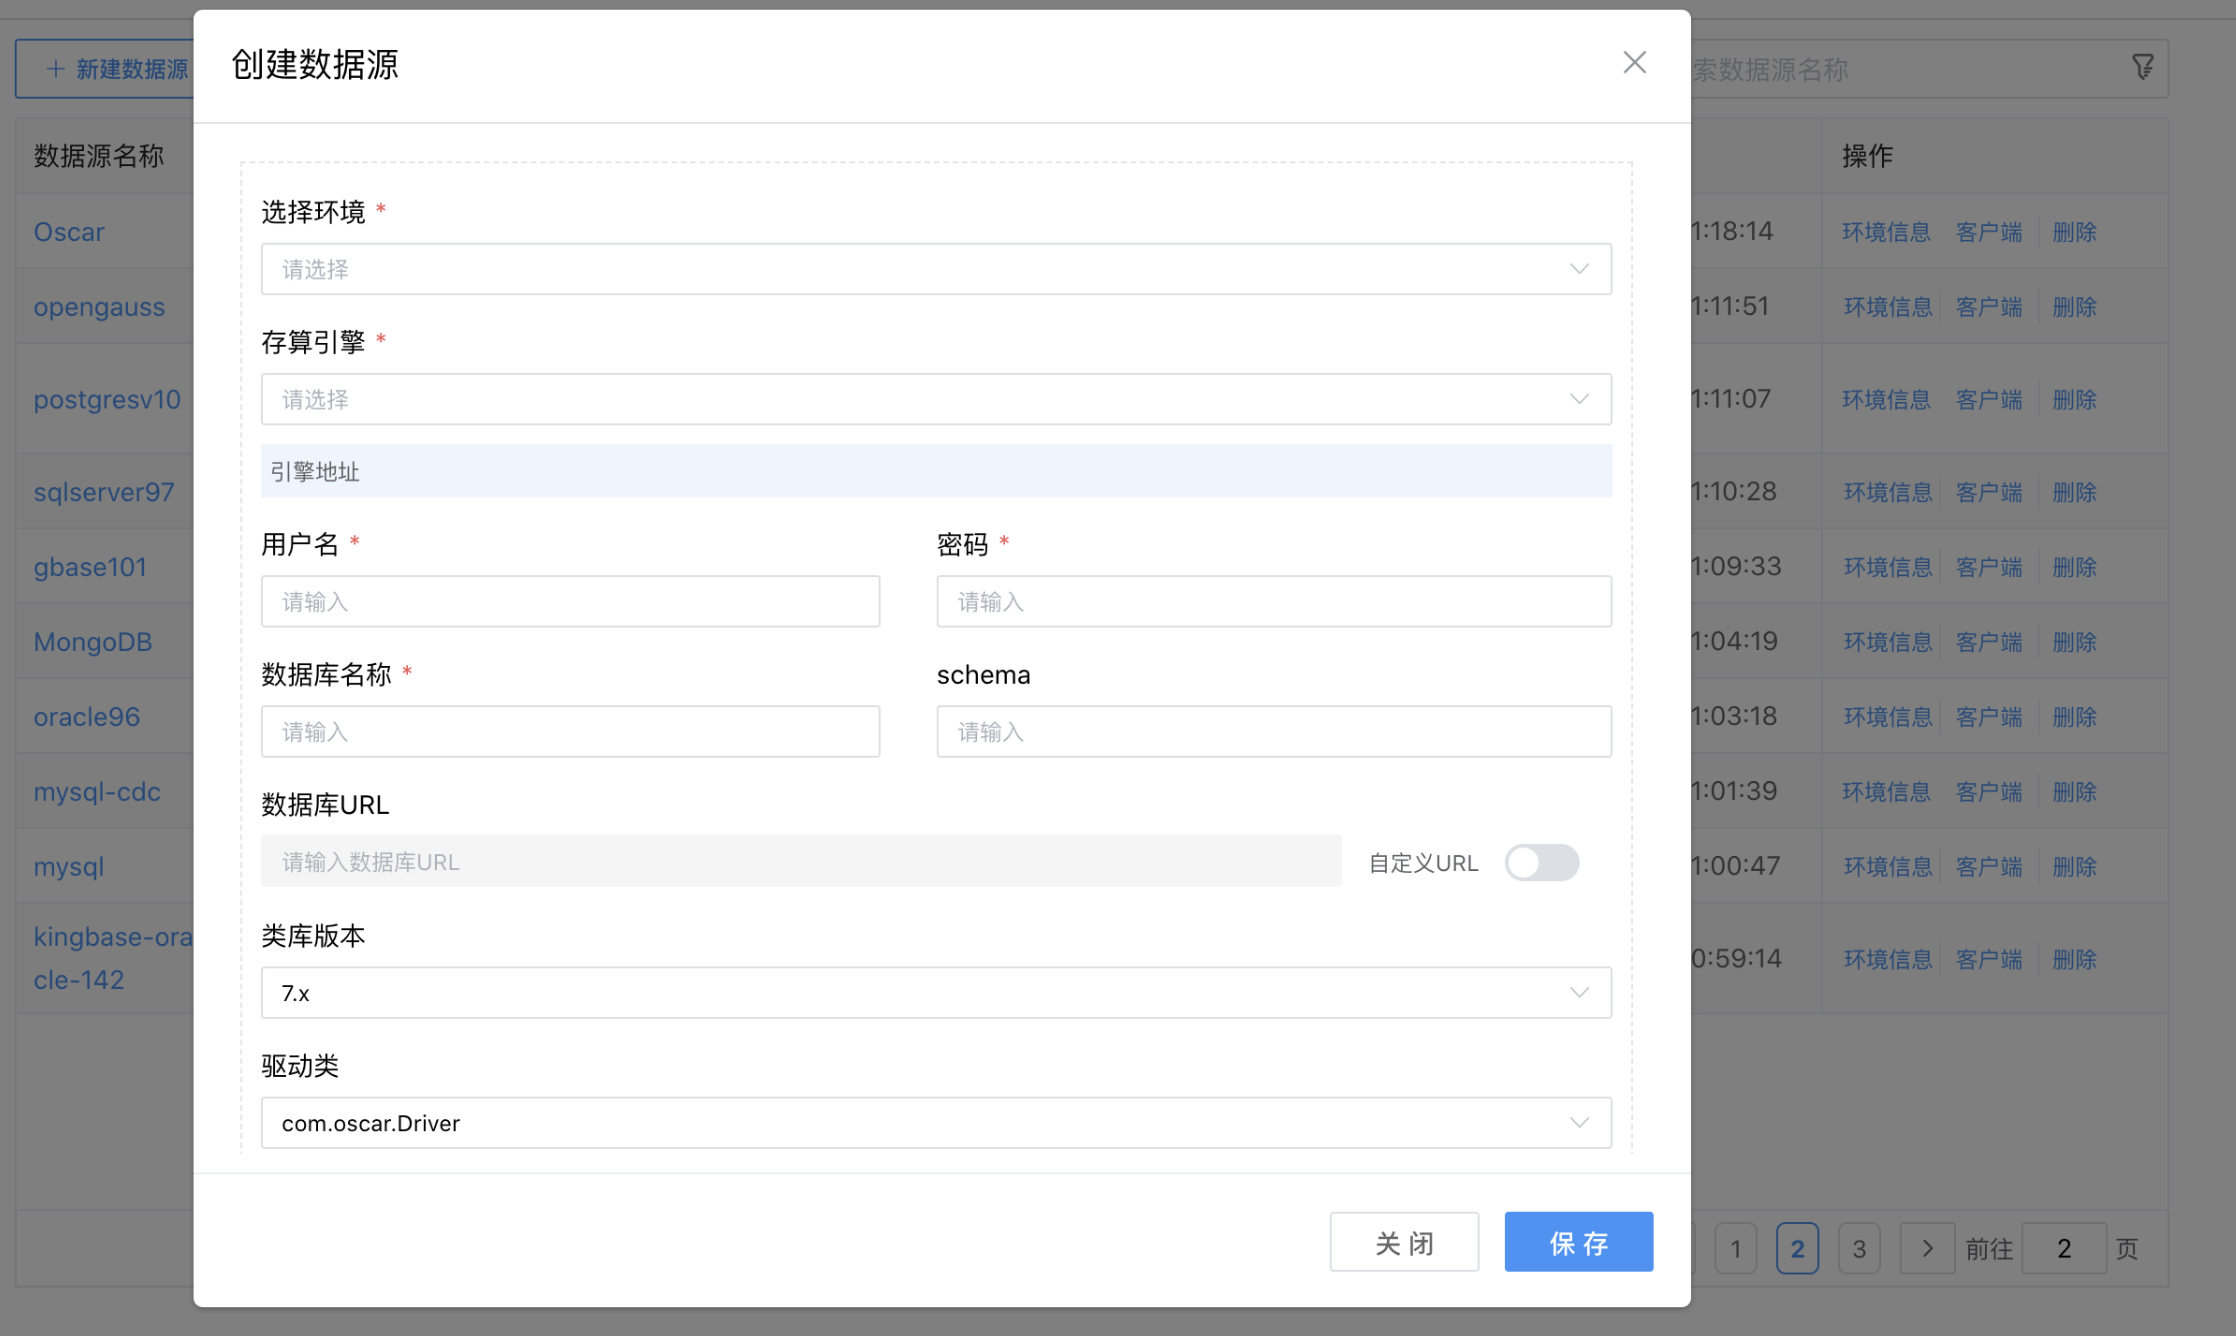
数据源环境配置项说明:
| 配置项 | 描述 |
|---|---|
| 选择环境 | 从下拉列表中选择:开发环境、生产环境、……。 |
| 存算引擎 | 数据源对应的存算引擎。 |
| 用户名 | 所配置的数据库的用户名。 |
| 密码 | 所配置的数据库的密码。 |
| 数据库名称 | 当前创建的数据源所属系统,从下拉选项选择(数据字典)。 |
| Schema | 数据库 Schema名称。 |
| 数据库URL | 自动生成的数据库URL连接地址。 |
| 自定义URL | 如果需要修改URL链接,可以启用开开关,然后进行手工修改。 |
| 类库版本 | 数据源的驱动版本号。 |
| 驱动类 | 数据源的驱动类。 |
| 连接参数 | 数据源的扩展参数。 |
| 连通性测试 | 测试数据源是否能正常连通。 |
点击【编辑】,可以修改当前数据源环境连接配置参数。
点击【删除】,可以删除当前数据源环境连接配置。
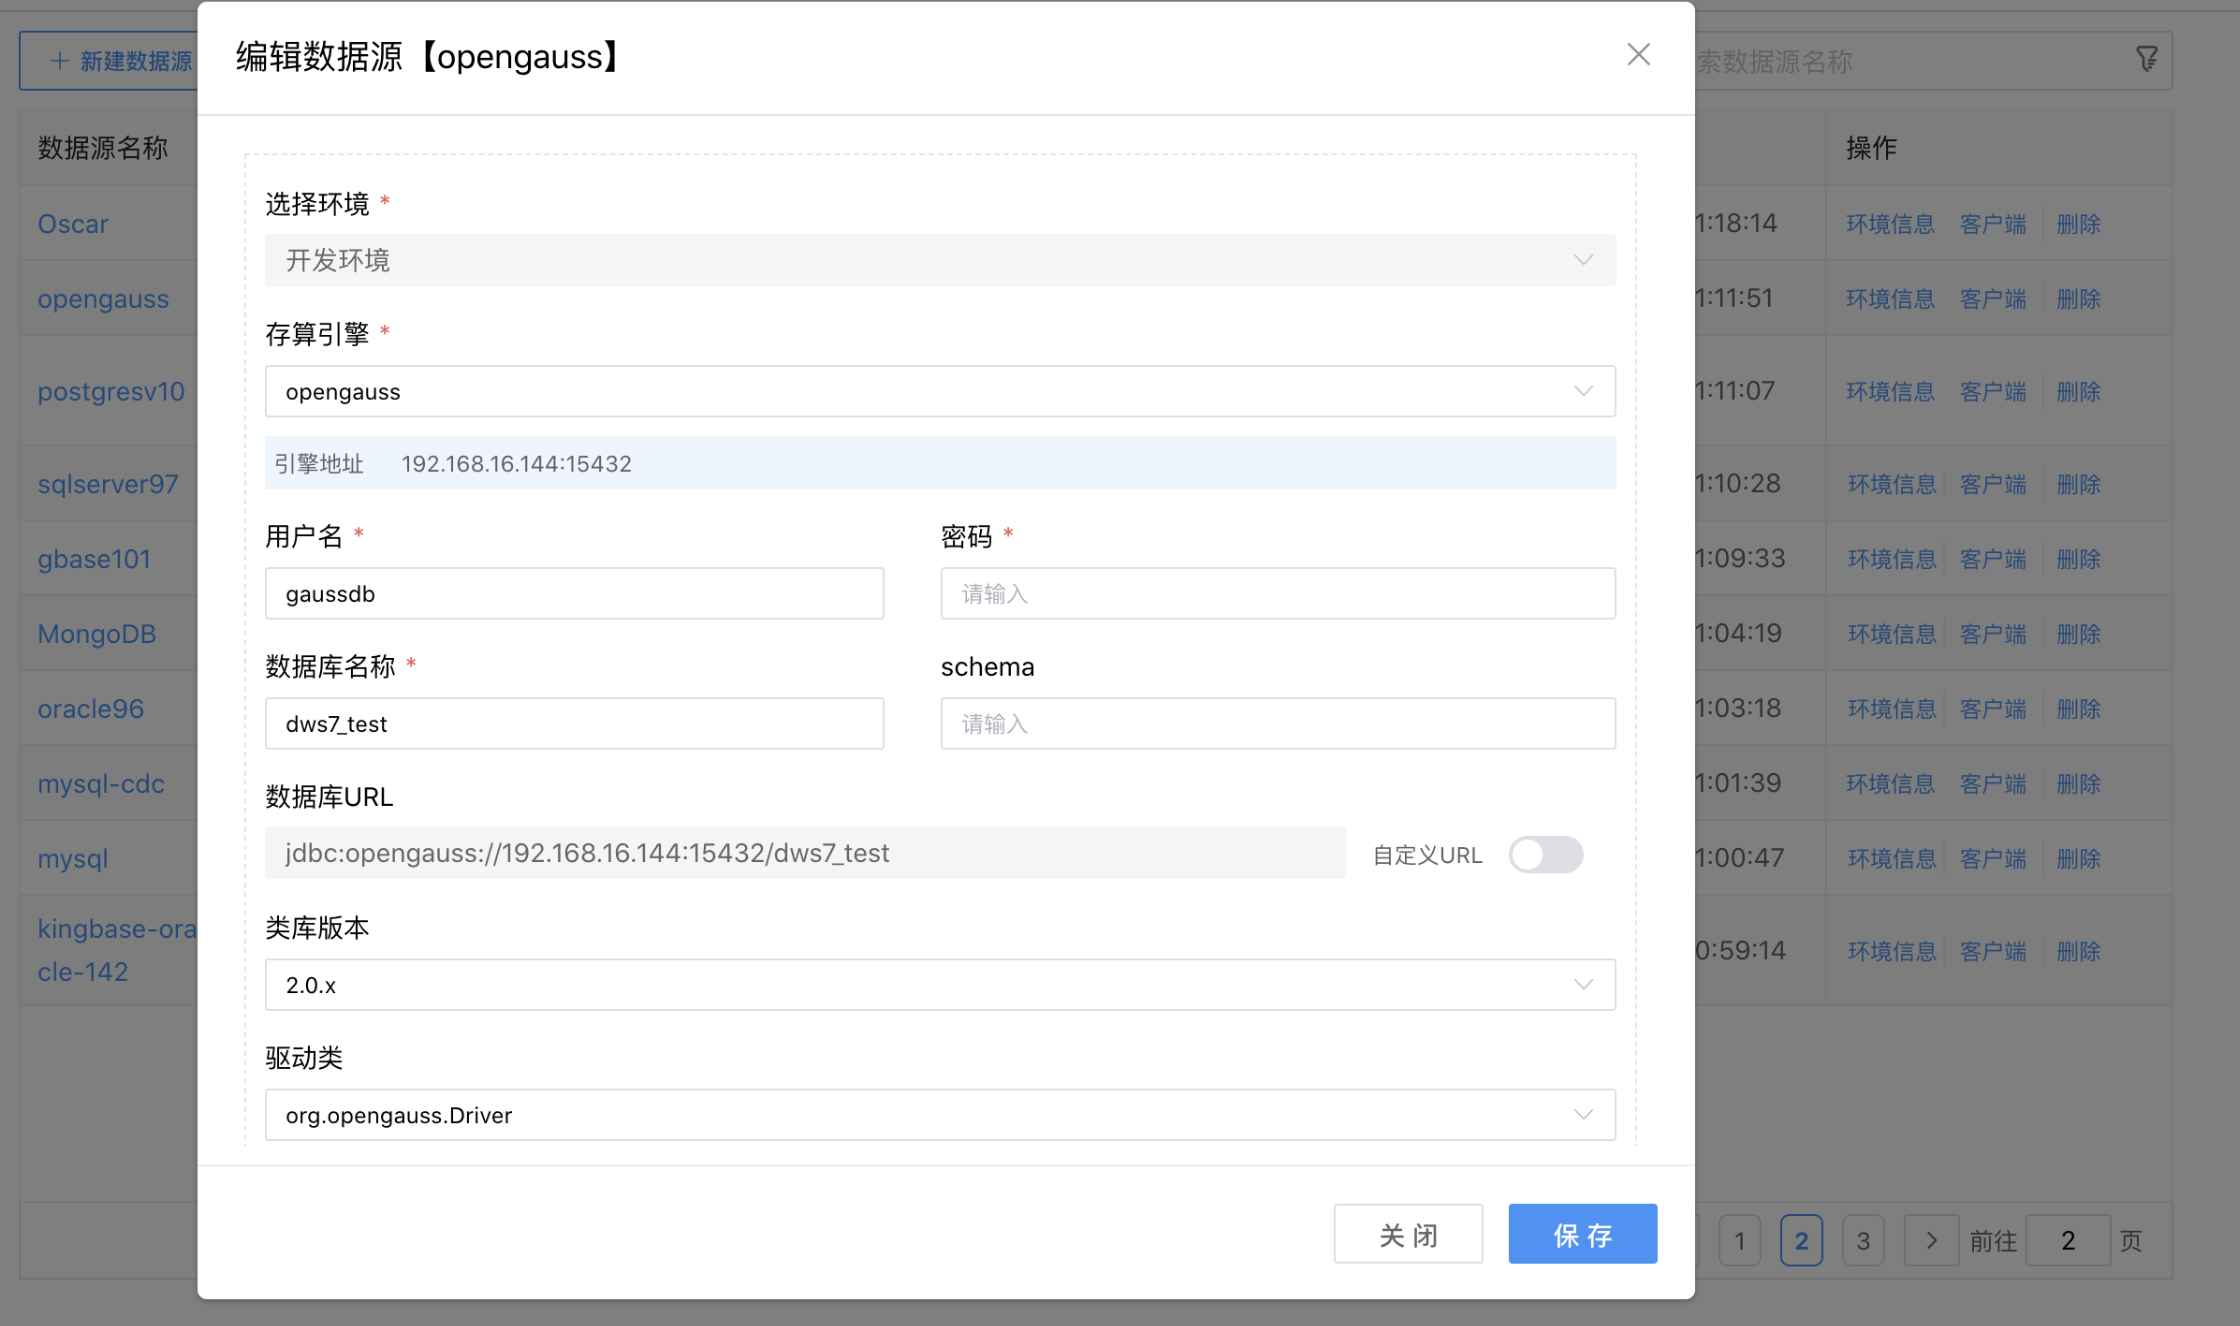
SQL客户端是一种在线浏览数据源信息的工具。支持数据库/Schema、表、视图、触发器、存储过程、列、索引、约束、分区、表数据、SQL语句执行/停止等;SQL编辑器语法高亮、提示、自动补全(数据库/Schema、表、视图、字段)。
支持关系型数据库,包括:MySQL、SQL Server、Oracle、IBM DB2、PostgreSQL、GBase(南大通用)、DM(达梦)、KingbaseES(人大金仓)、openGauss、Oscar、HighGo(瀚高)、OceanBase、UXDB(优炫)、XuguDB(虚谷)、TiDB、Vastbase(海量)、MariaDB 、AnalyticDB-MySQL模式、AnalyticDB-PostgreSQL模式、TDSQL(PostgreSQL模式)、SAP HANA。
支持大数据,包括:ArgoDB、Doris、Hive、Clickhouse、StarRocks、Inceptor(星环)、MaxCompute。
点击数据源列表后边的【SQL客户端】按钮,会打开新的浏览器Tab页,可以浏览当前数据源的信息。
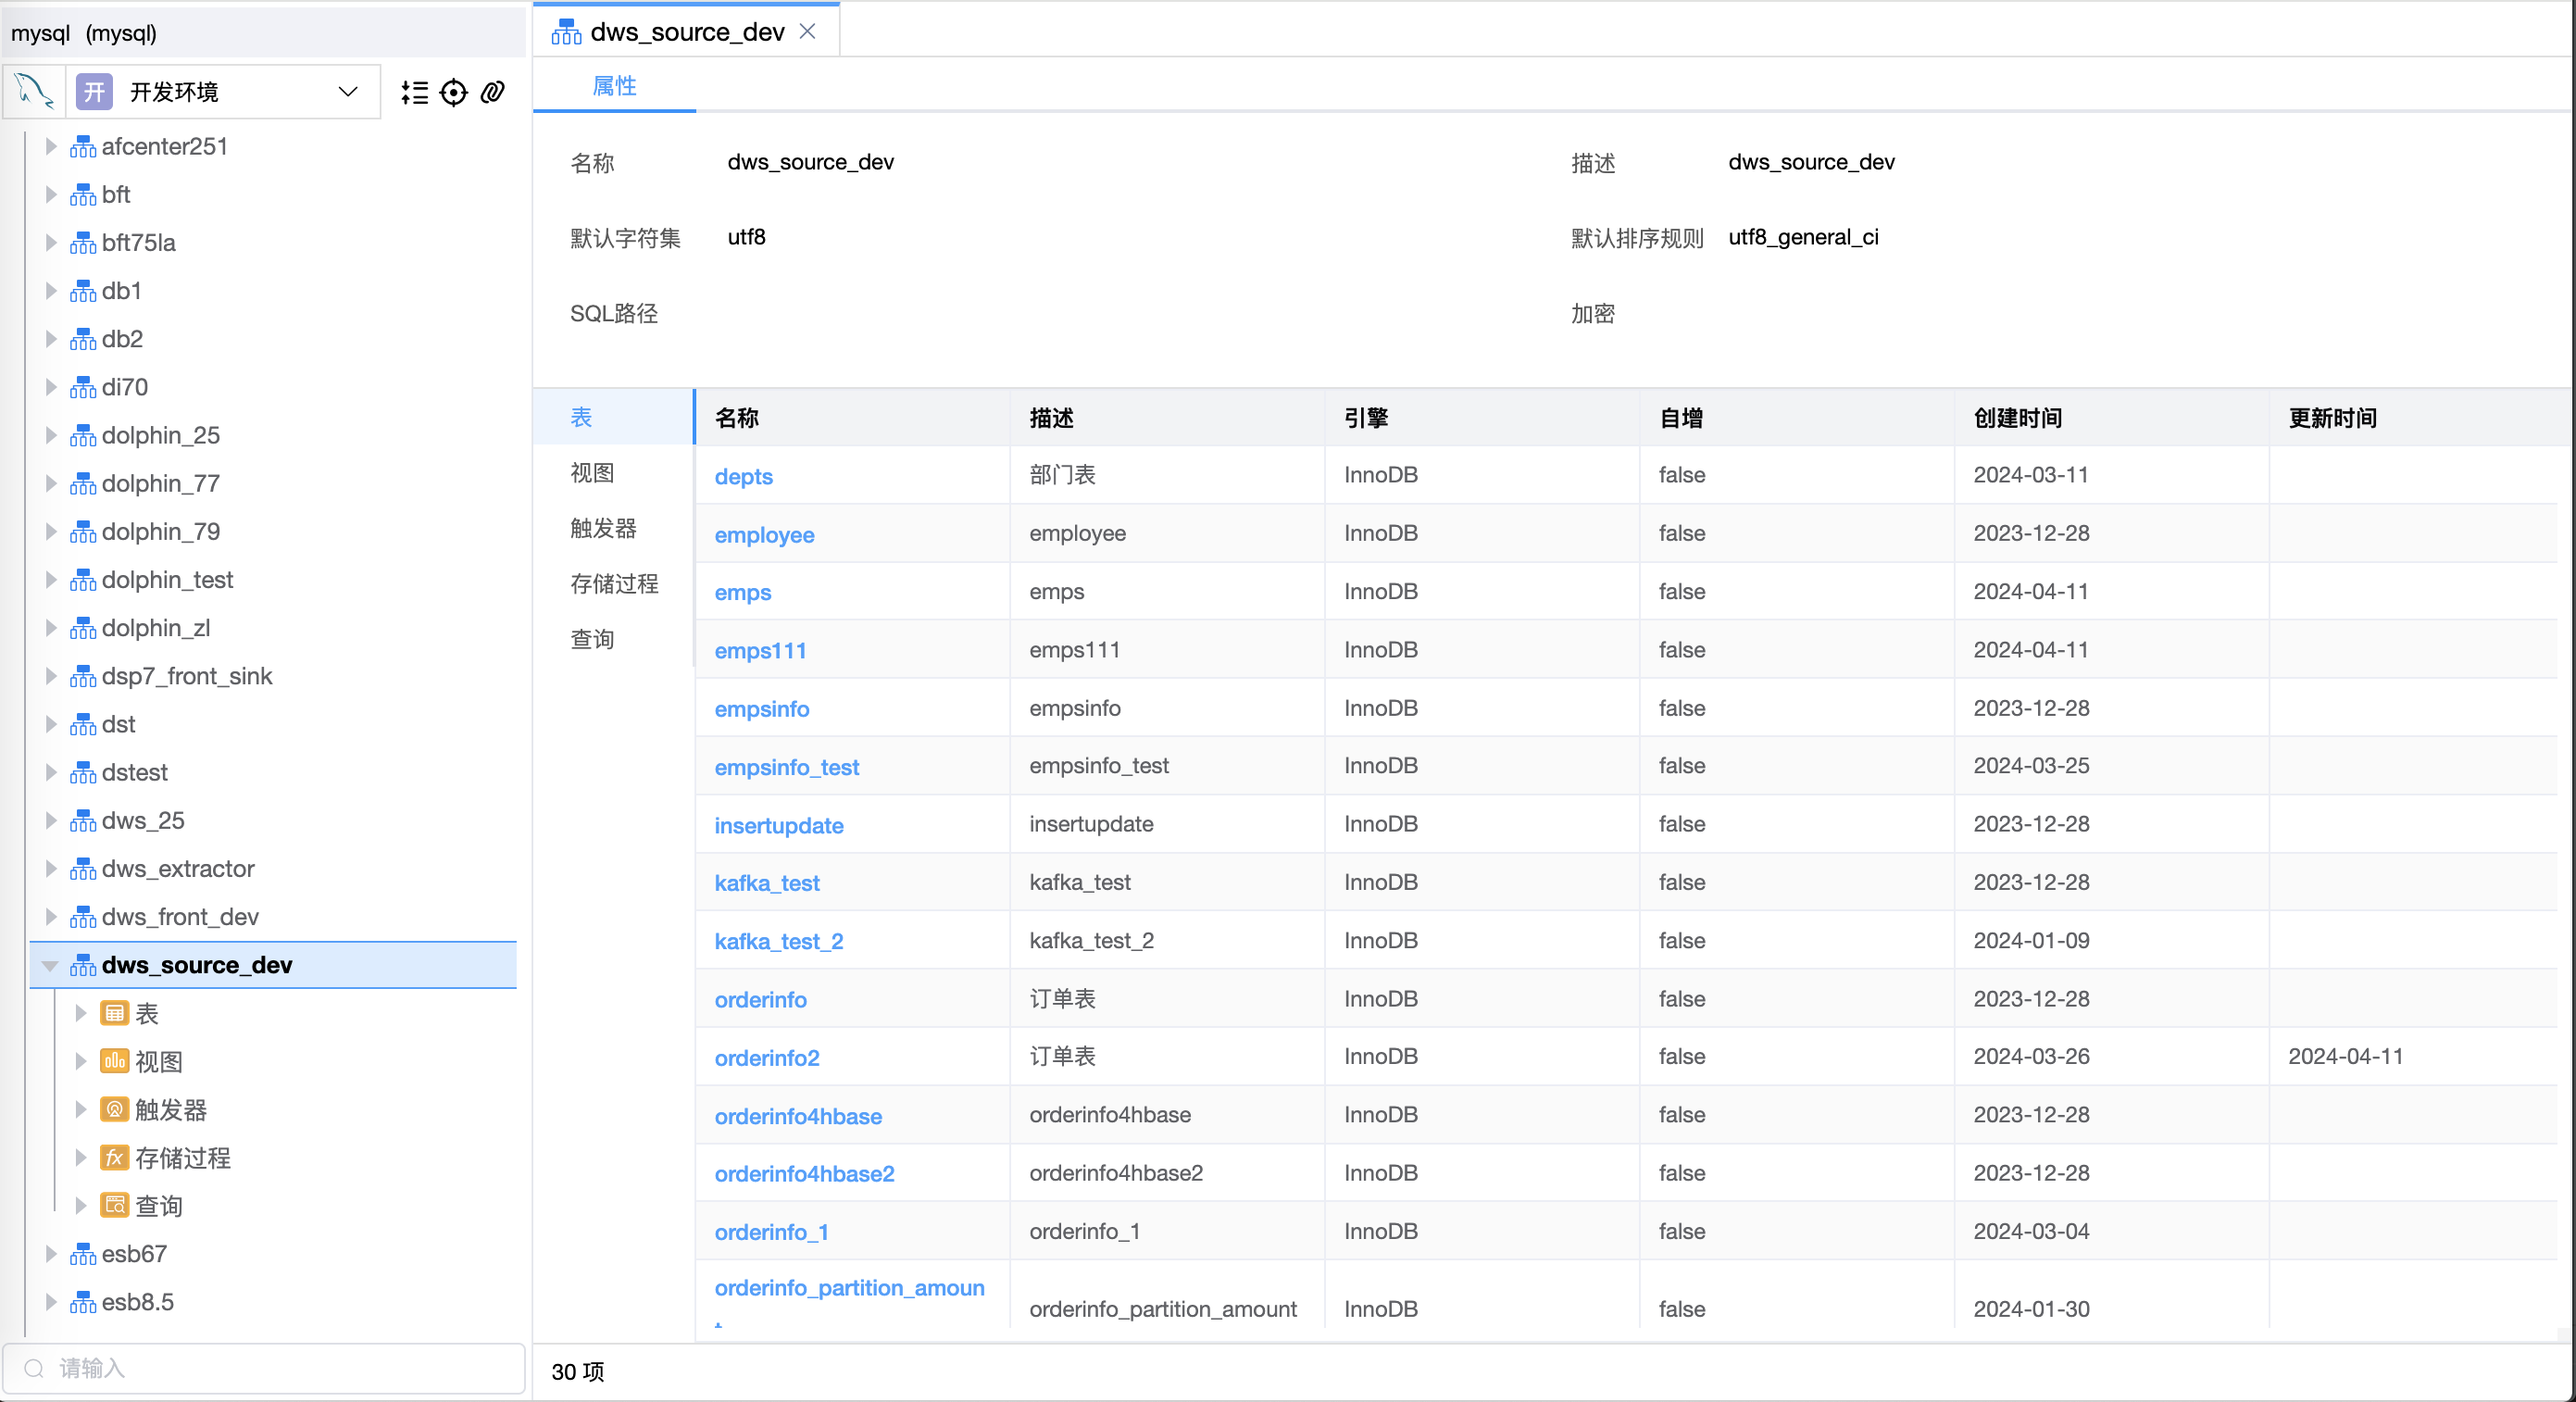
SQL智能助手具备 AI 推理和自然语言处理能力,在数据开发场景下,可以帮助开发者根据自然语言快速完成多种 SQL 代码的相关开发,包括:数据定义语言(DDL)、数据操作语言(DML)、数据查询语言(DQL)、数据控制语言(DCL),纠正 SQL 语句的错误,对 SQL 语句性能进行优化,生成 Mock 数据,查找表等。
SQL AI 助手有两种使用场景,核心区别在于是否开启【当前数据库】开关
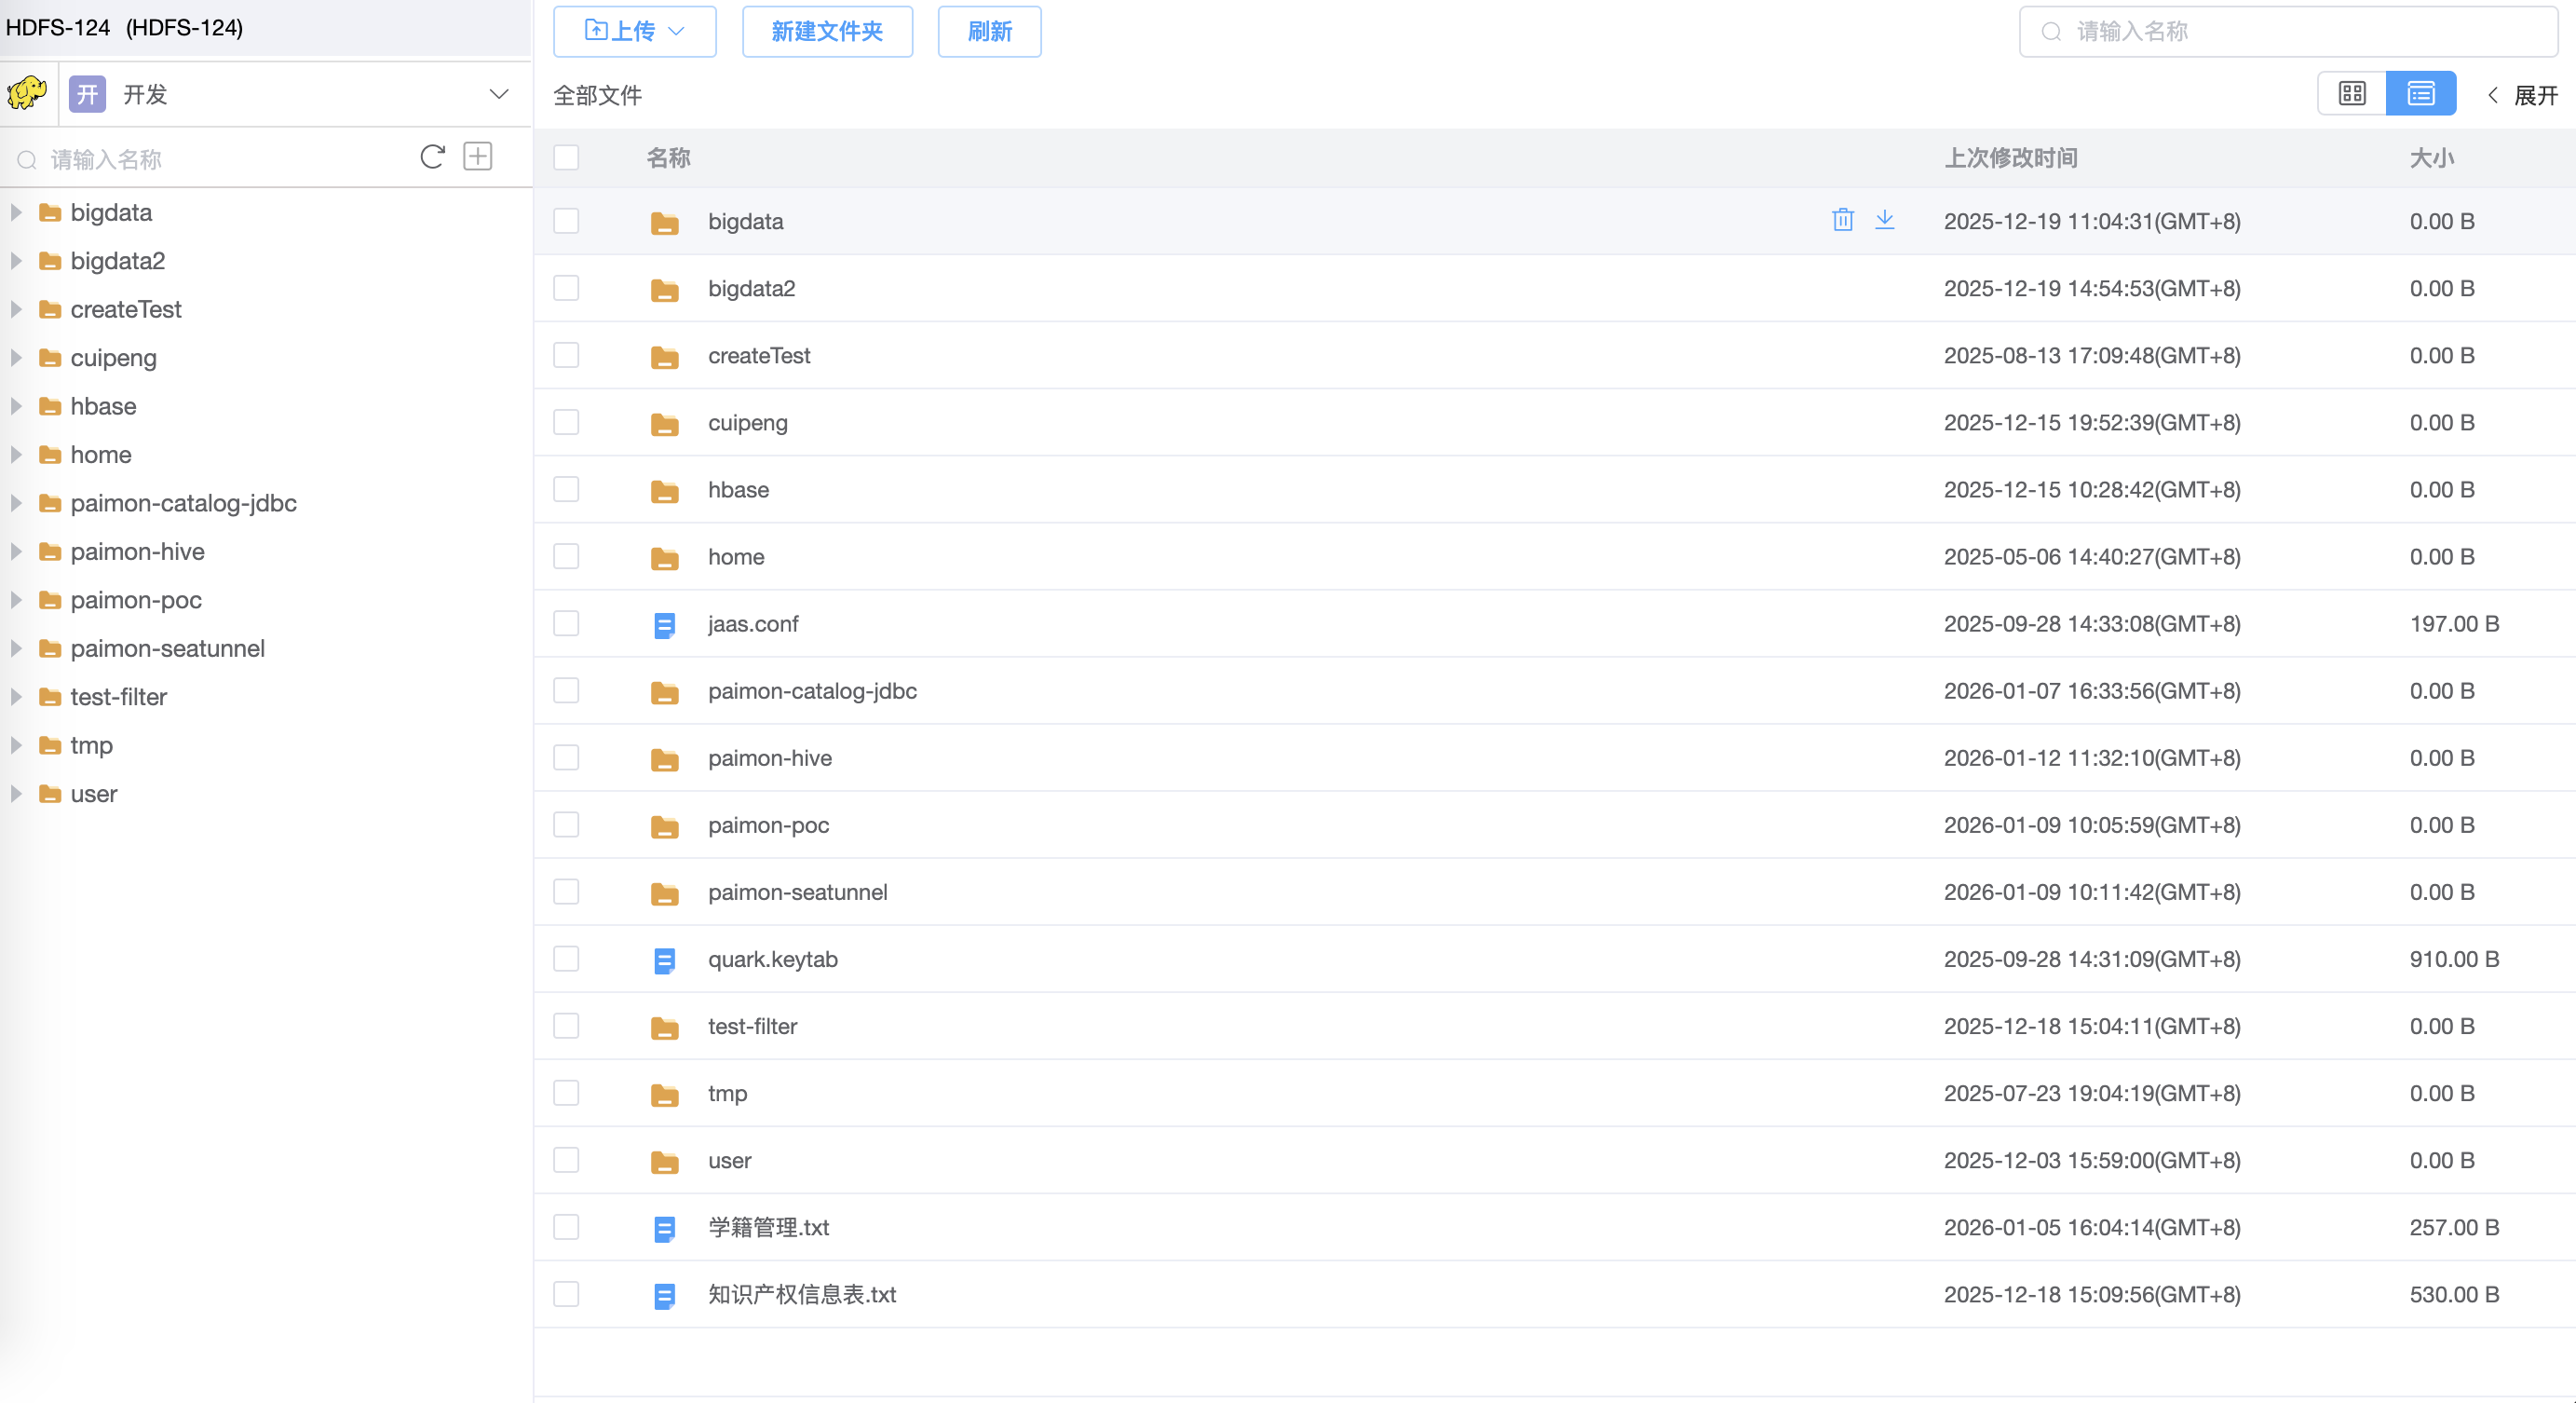
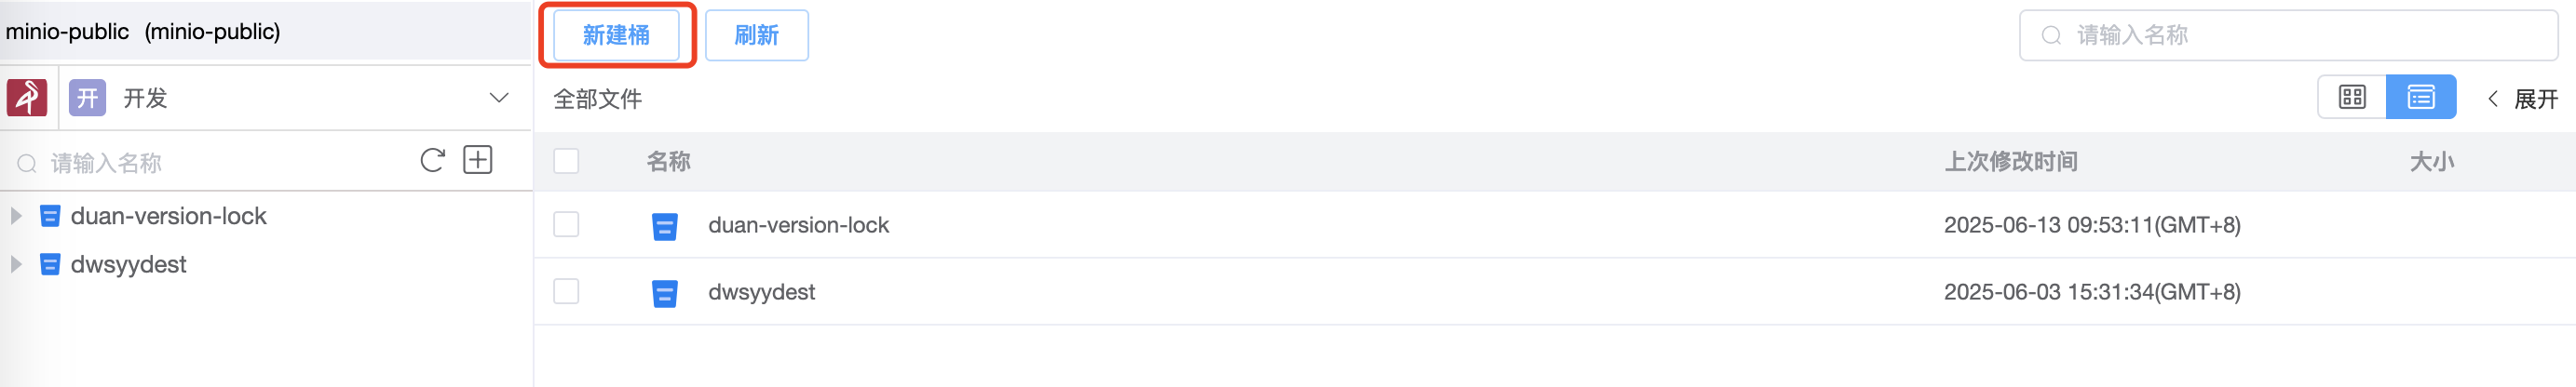
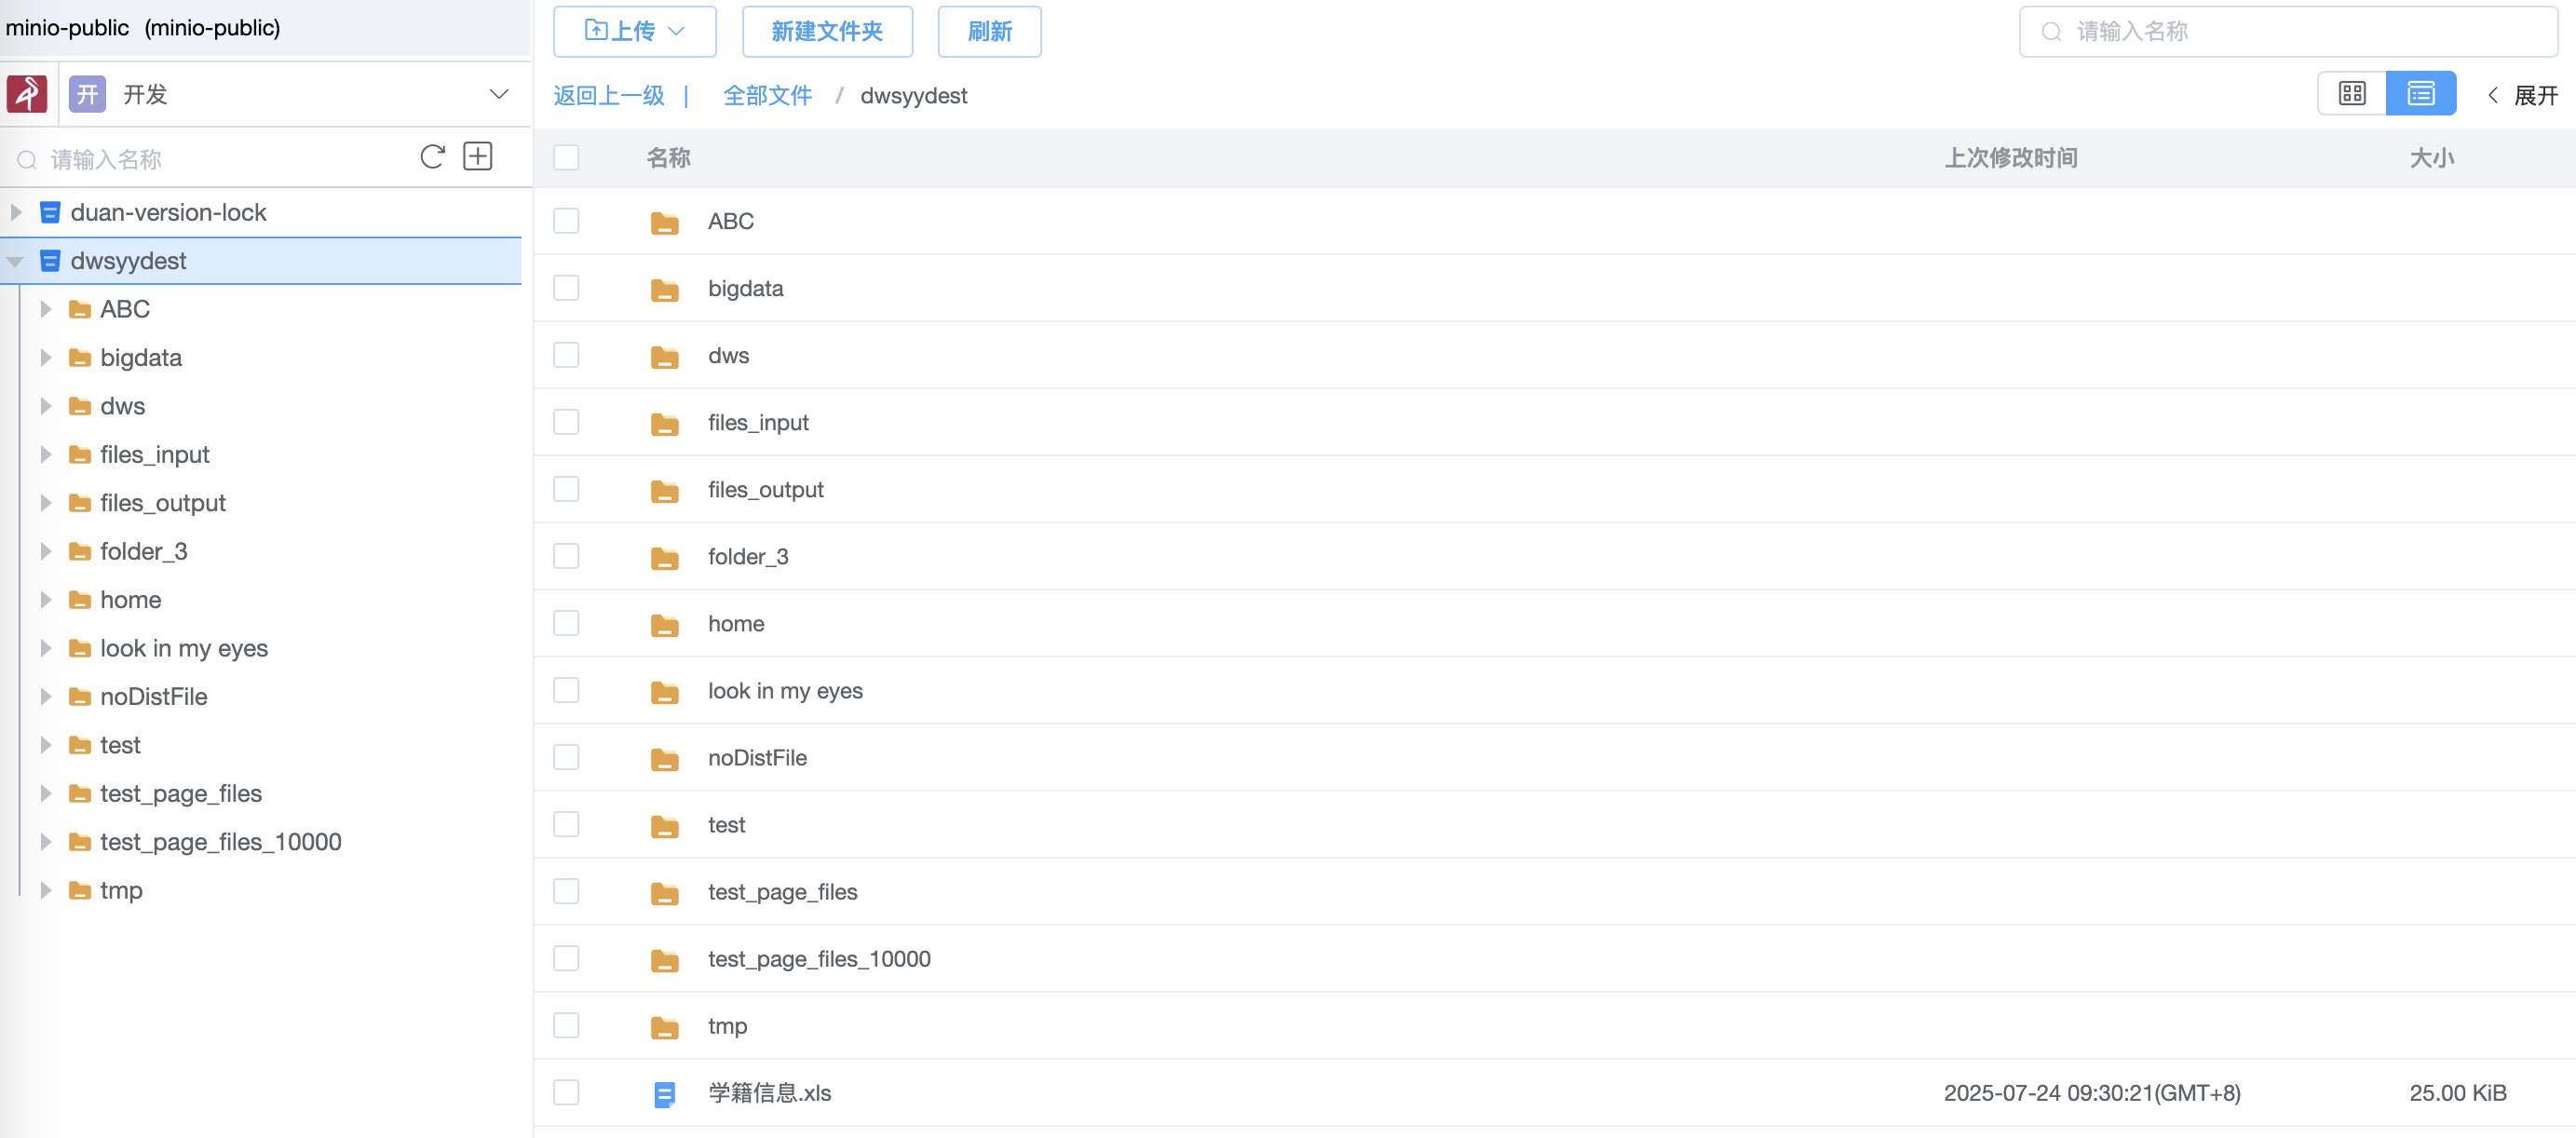
文件客户端支持HDFS、S3、MinIO等文件/对象的上传、下载、浏览。
HDFS 类型的客户端界面如下:
对象类型的客户端界面如下,默认显示的是桶下的资源,此时可以【新建桶】。
选择左侧一个桶后,显示该桶下的存储的文件/对象。
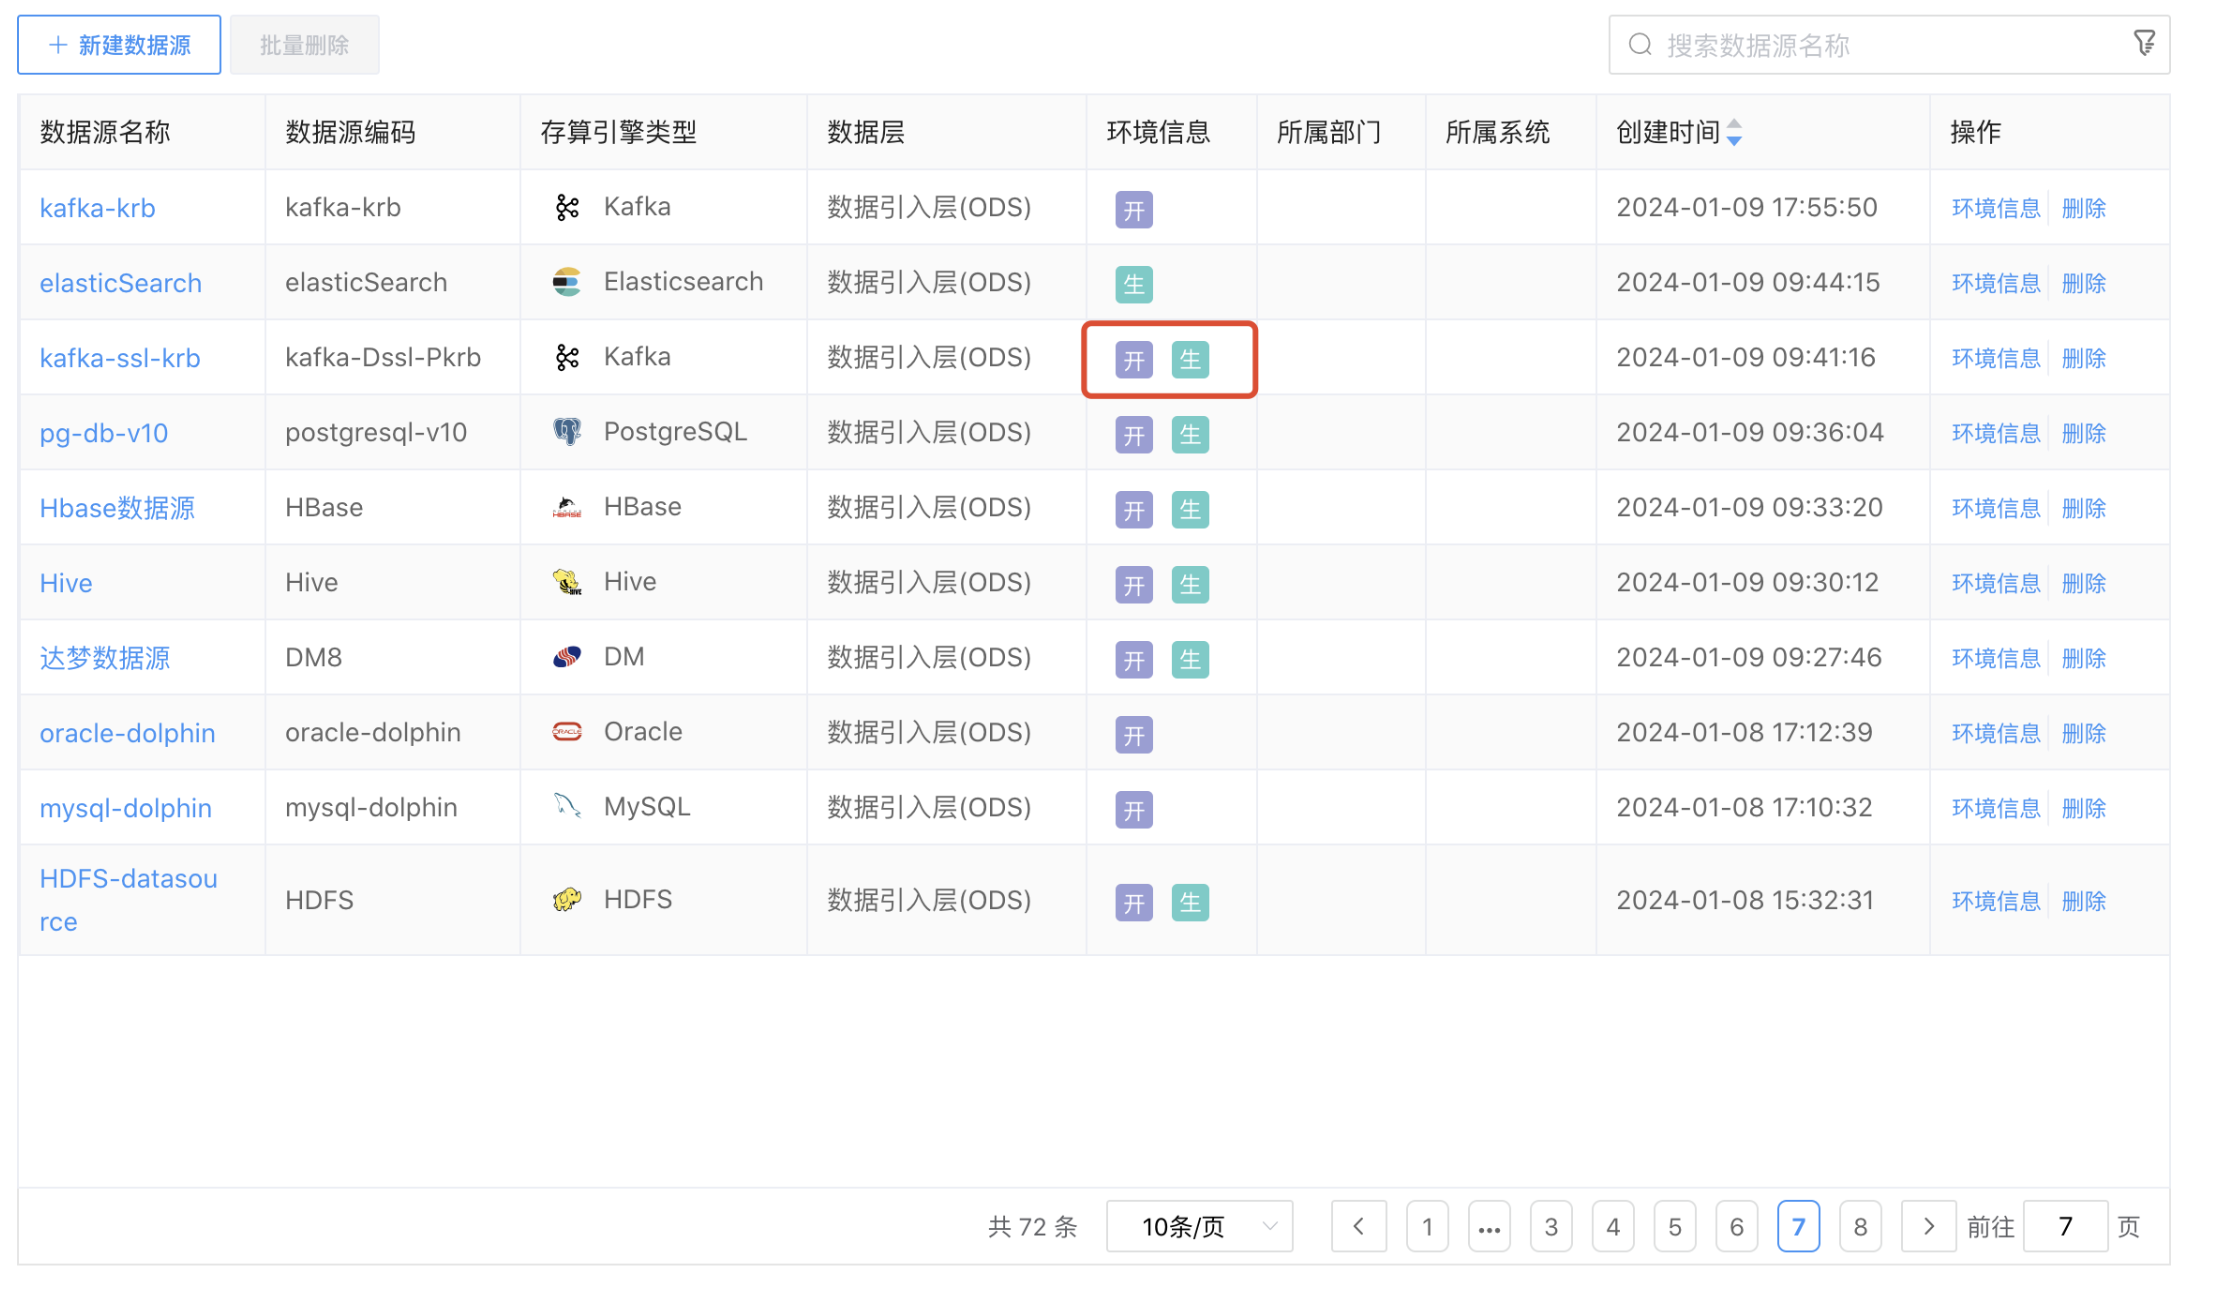
点击数据源列表后边的【连接信息】按钮,弹出"连接信息"弹窗,可以查看各个环境的数据源连接信息。
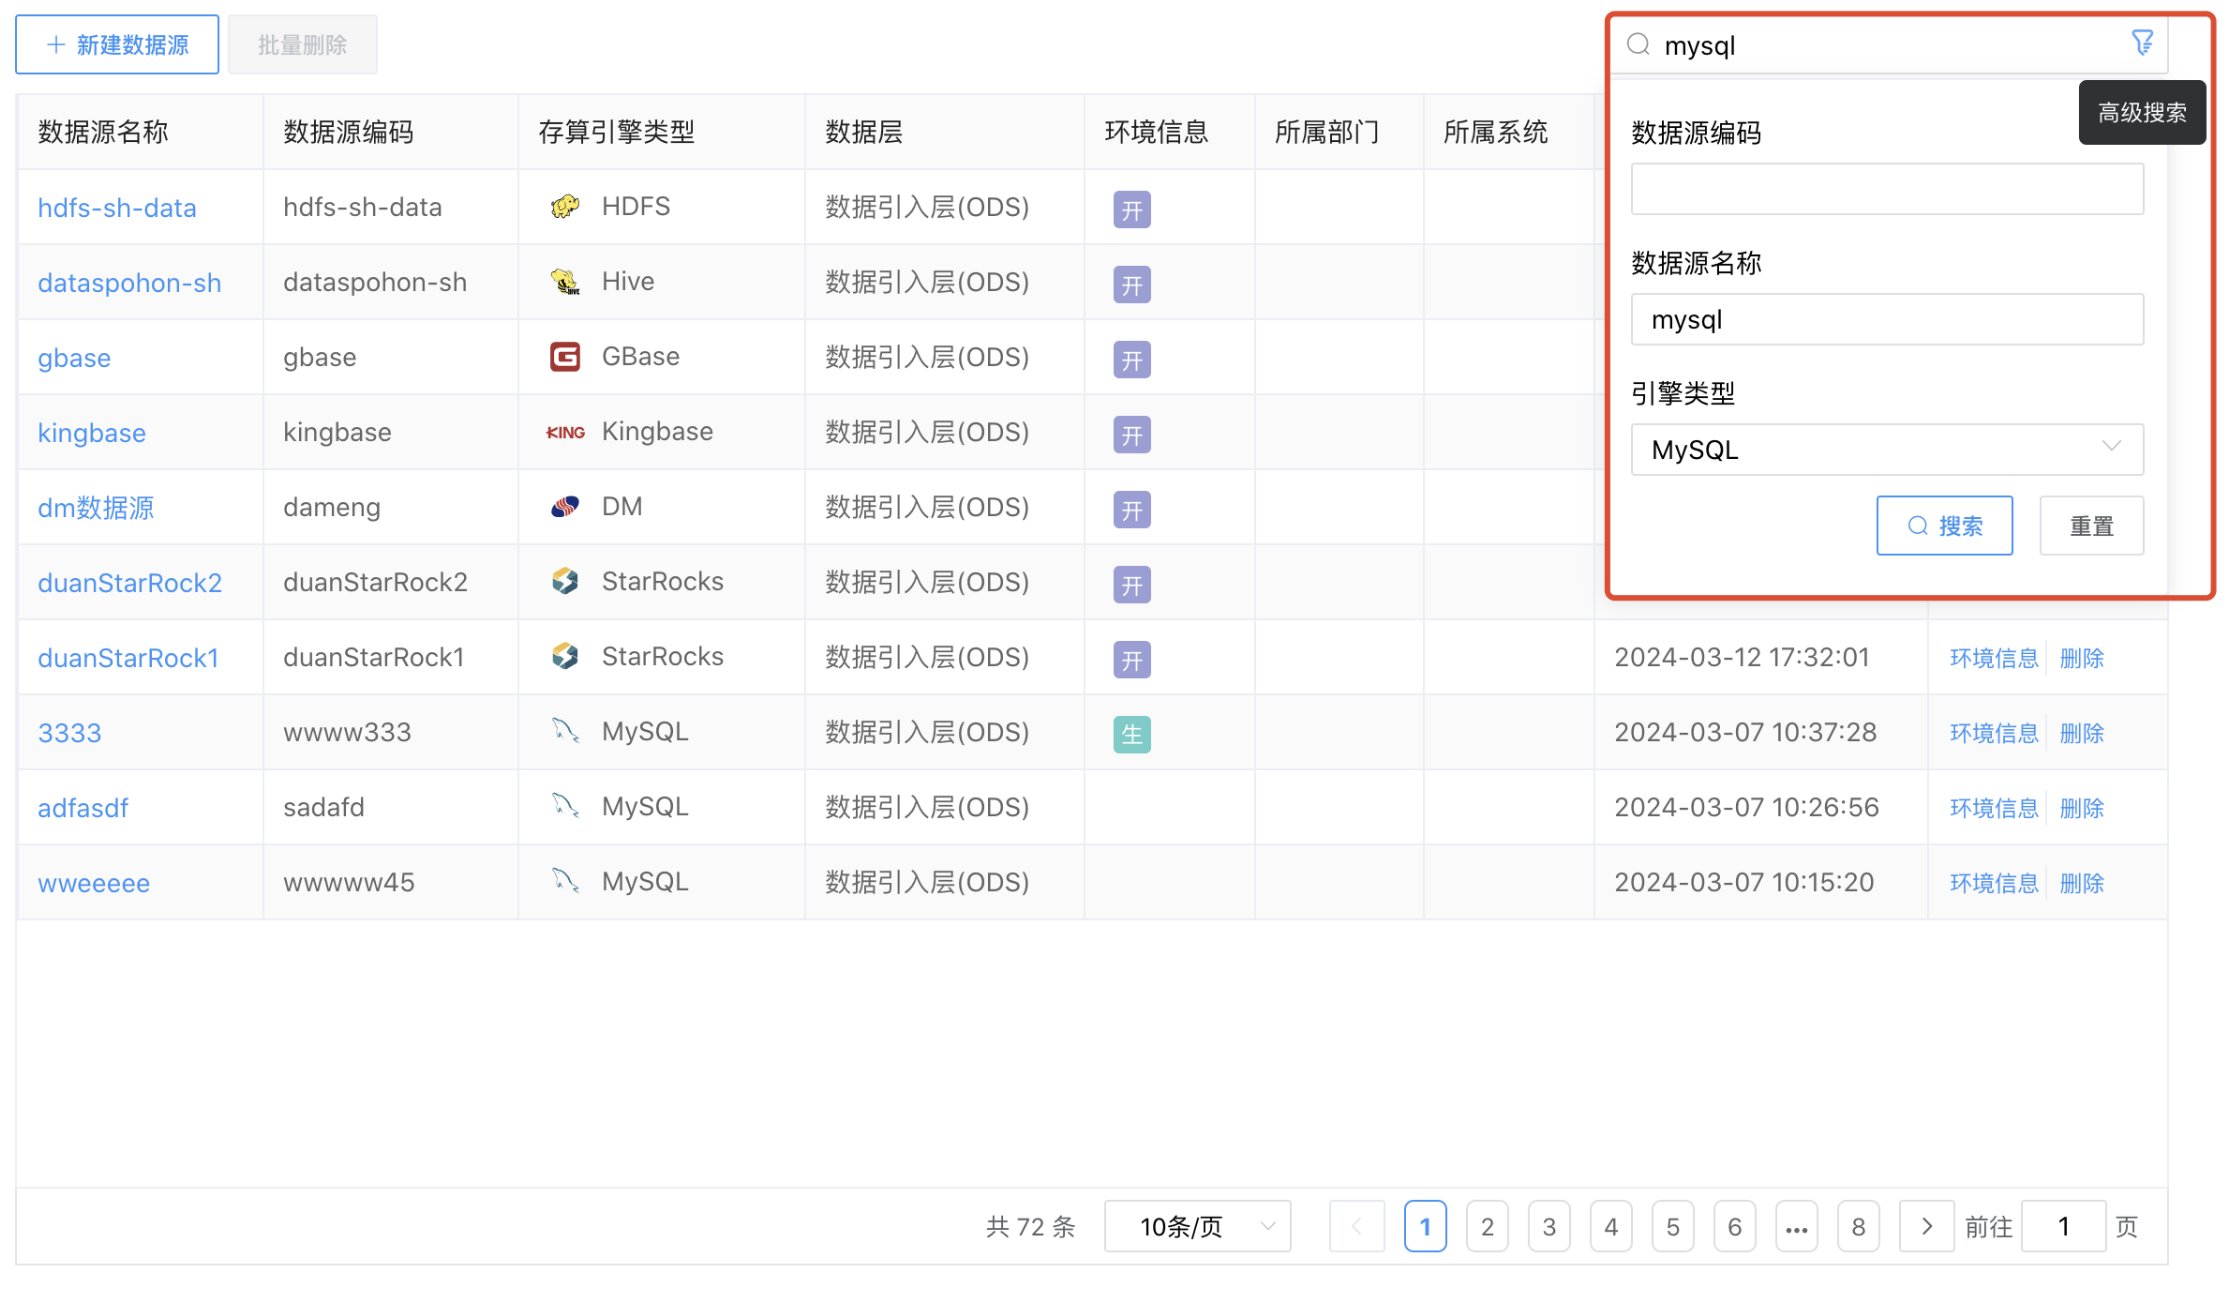
点击存算引擎列表右上方的【高级搜索】按钮,输入搜索条件"数据源编码"或者"数据源名称",点击【搜索】按钮,可以按照条件完成数据源的模糊查询,点击【重置】按钮,可以清空搜索条件。
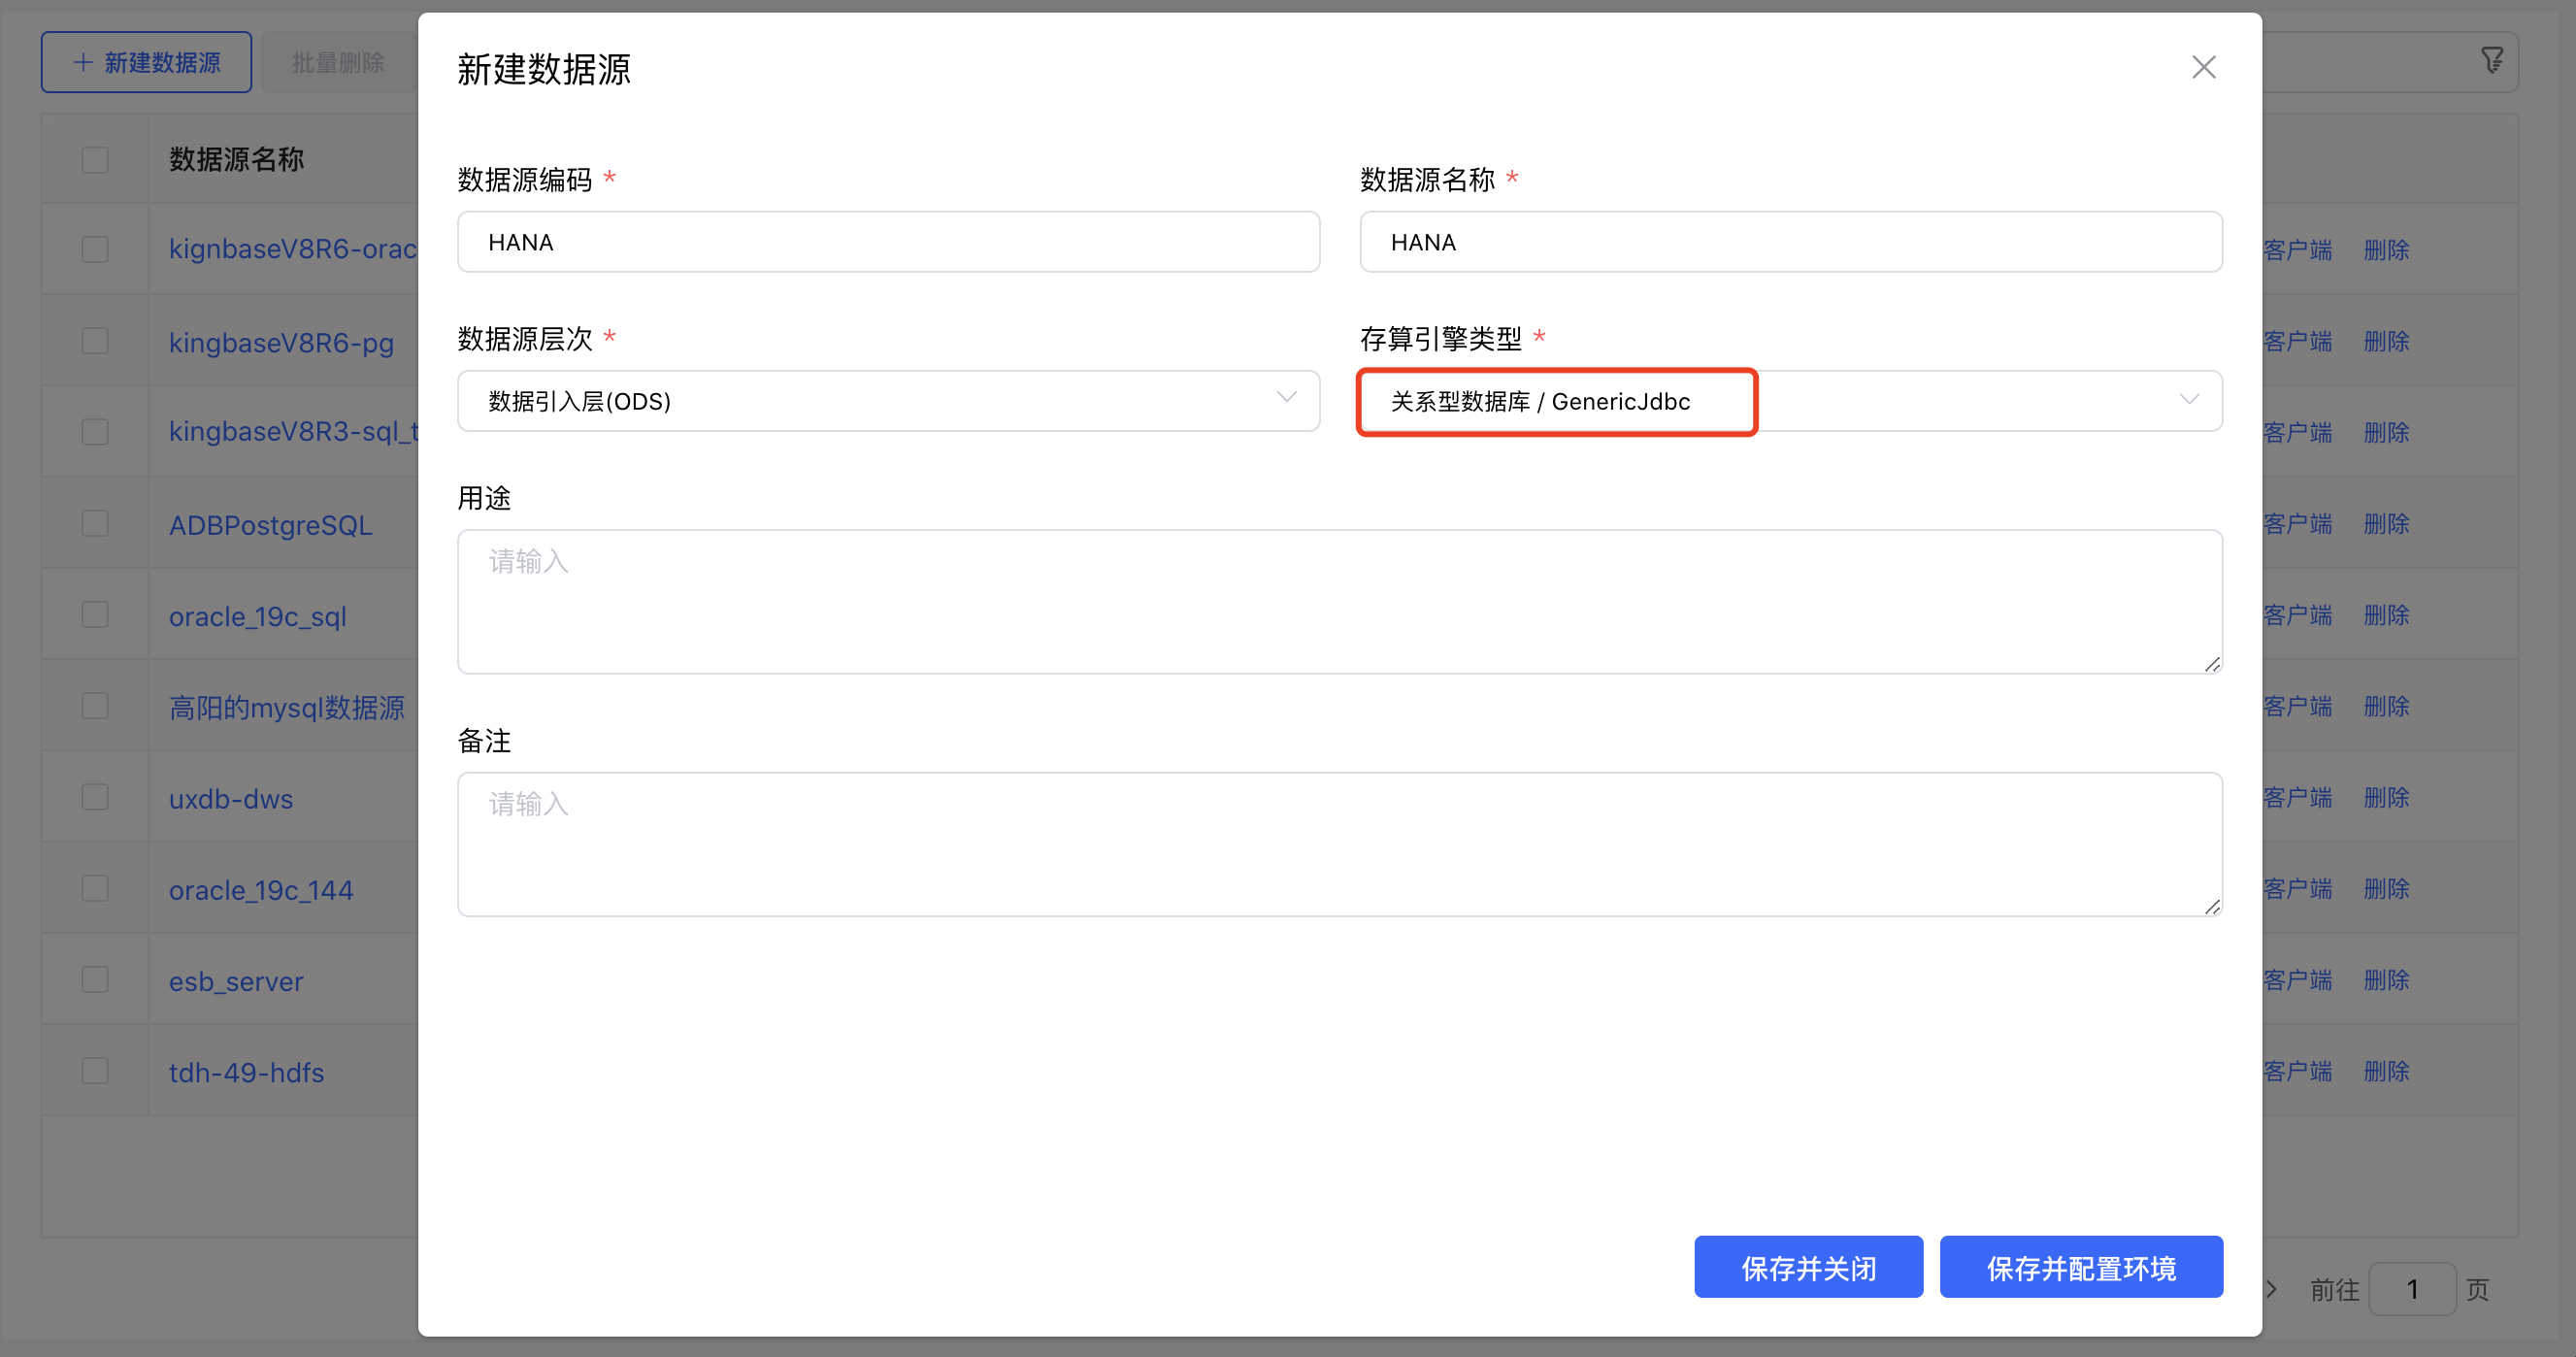
Generic JDBC 存算引擎能快速接入更多关系型数据库,是通用的关系型数据库 jdbc 连接方式。
以下以 Generic JDBC 类型创建 HANA_SAP 数据源为例说明使用步骤。
创建存算引擎参考:HANA_SAP存算引擎
创建数据源
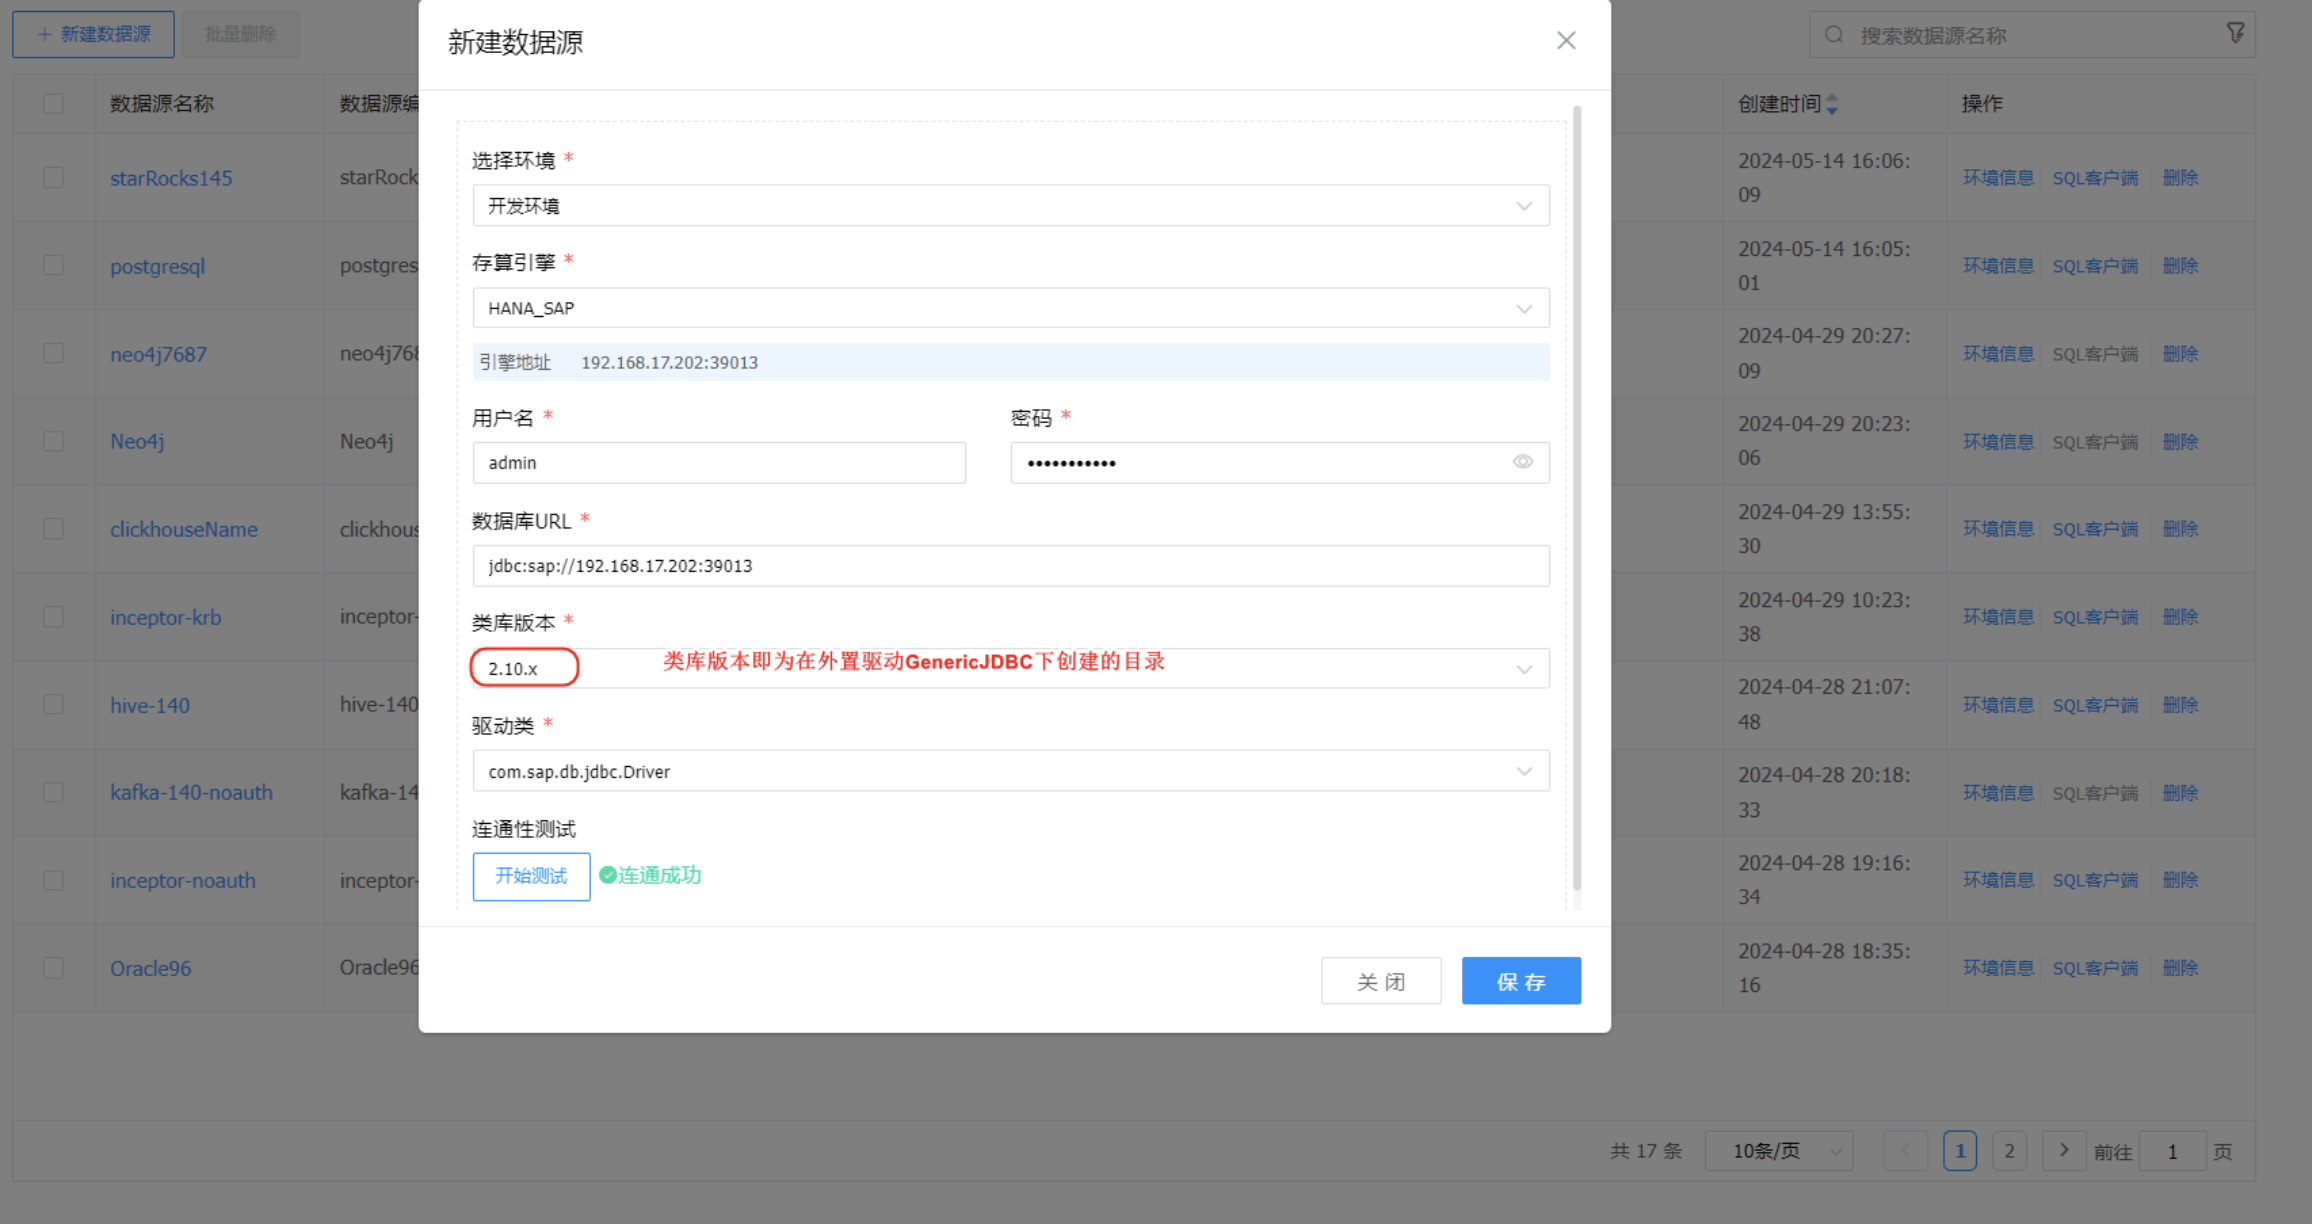
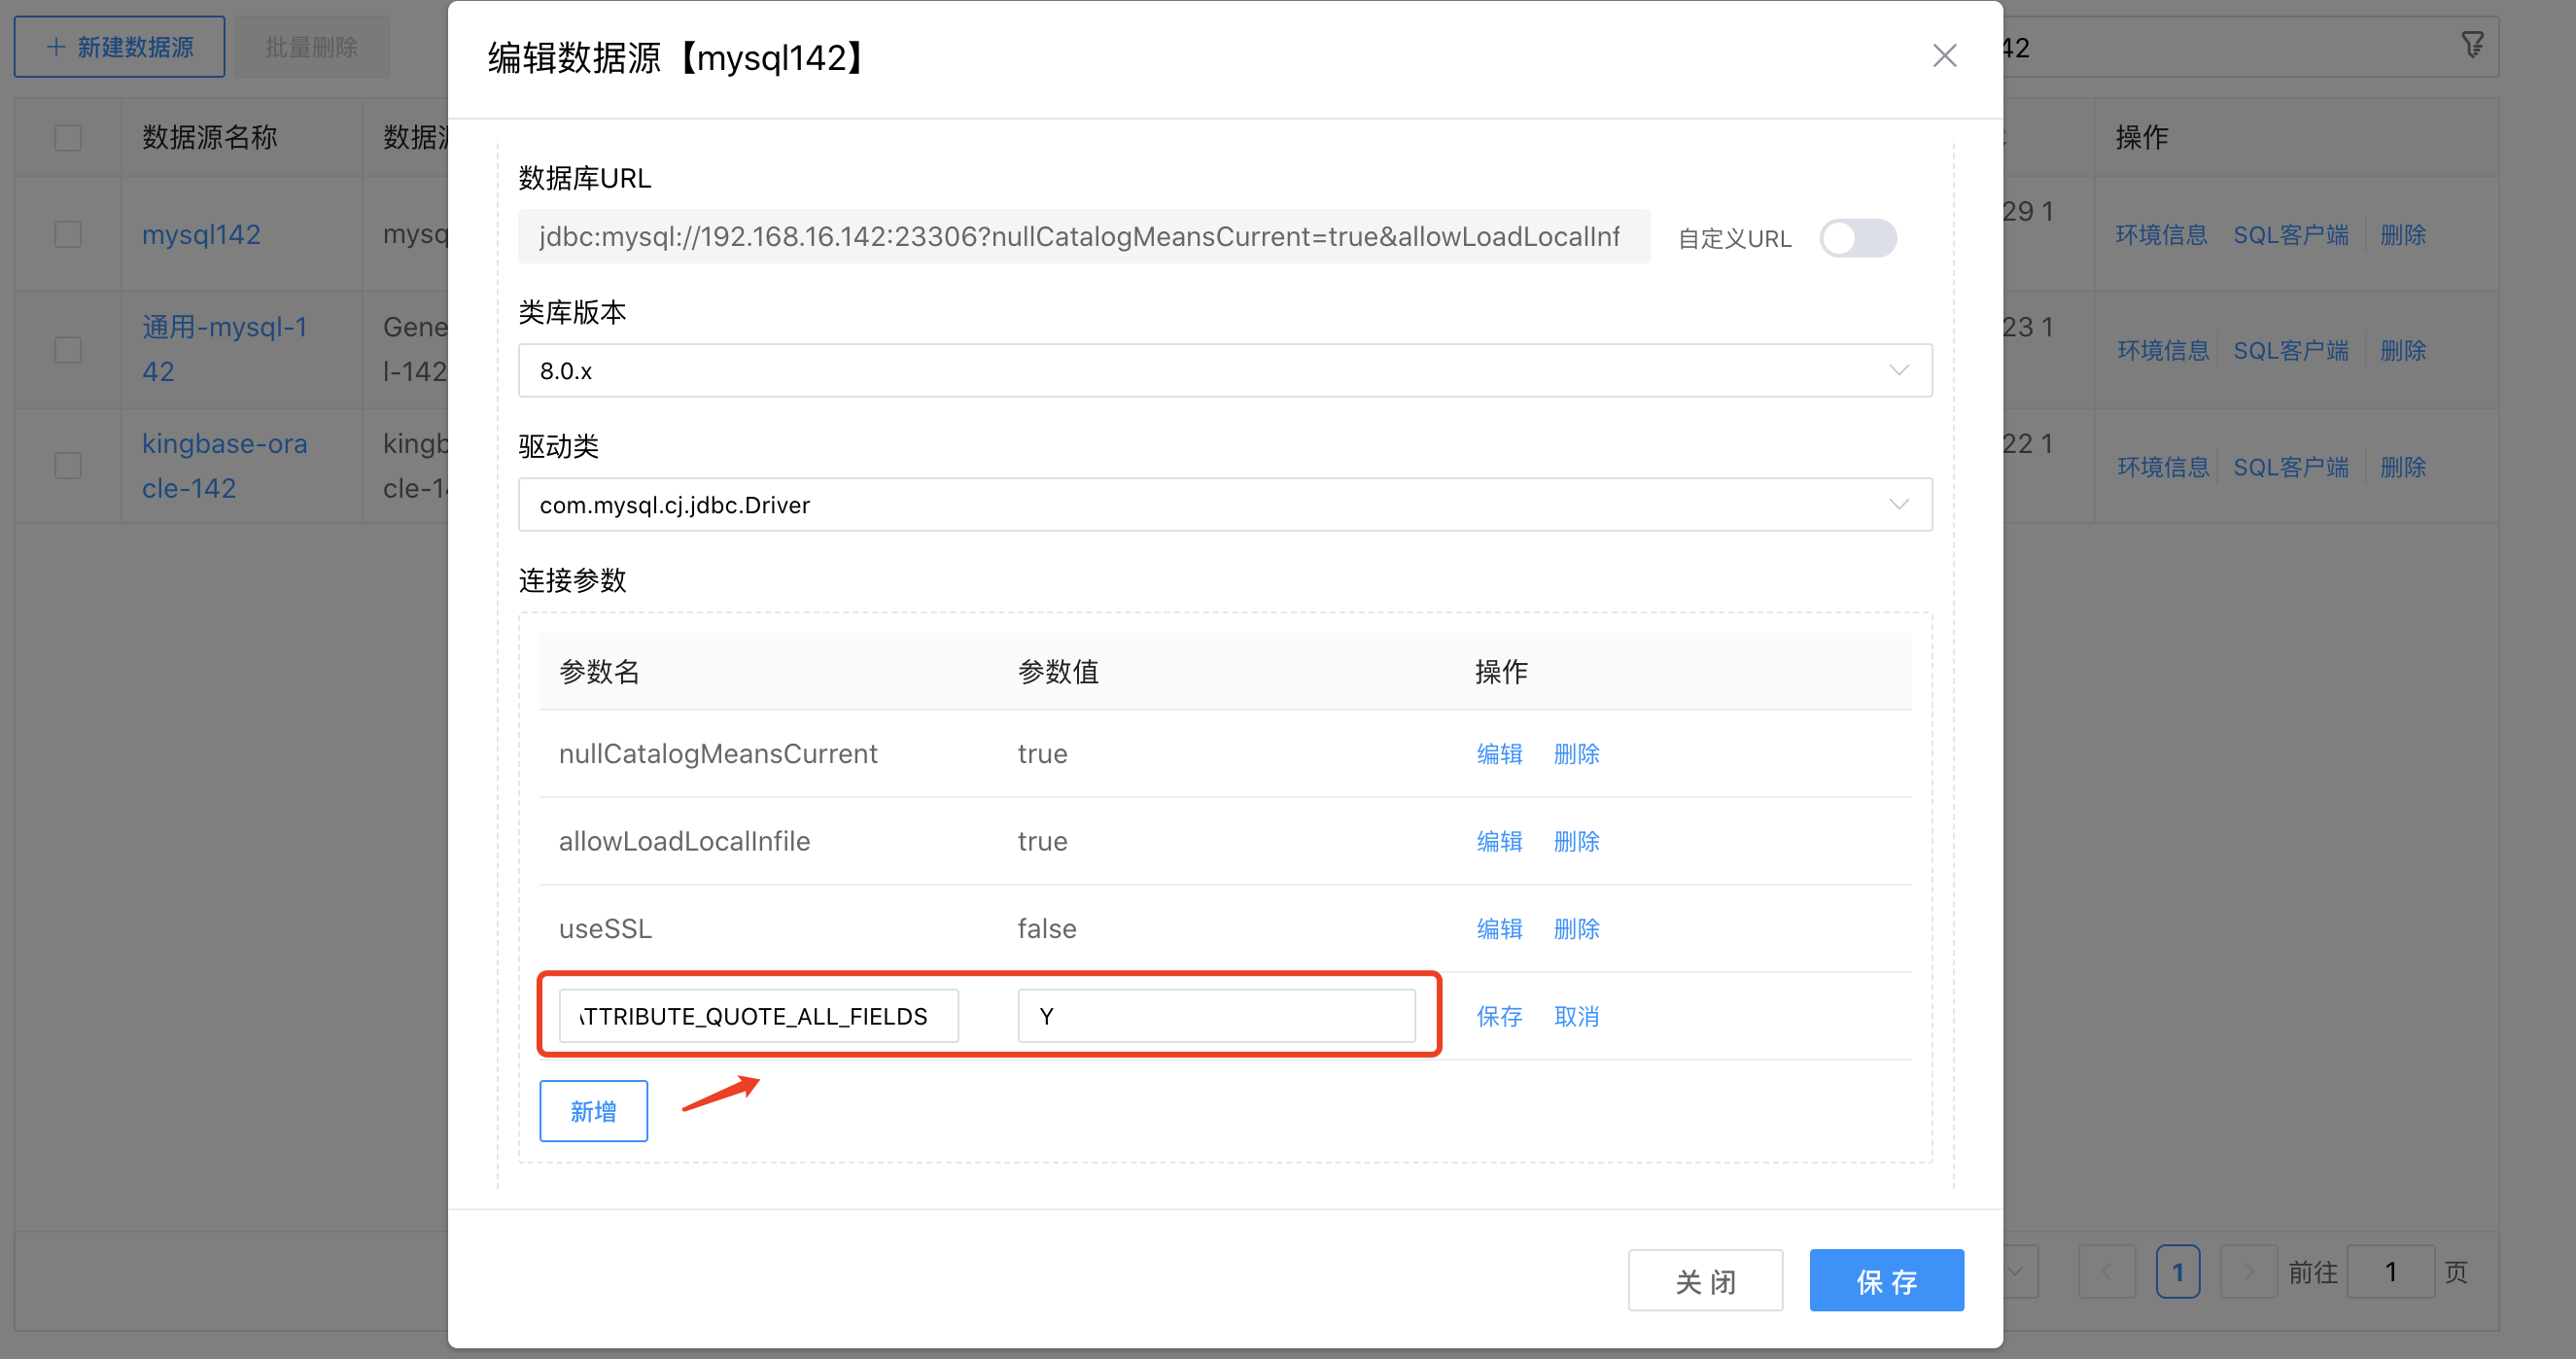
通过修改数据源配置参数,使名称(Schema/库、表、字段)规避数据库关键字重名冲突。
启用此配置可以规避名称与数据库关键字重名冲突的问题
DWS_ATTRIBUTE_QUOTE_ALL_FIELDS = Y/N; 含义:默认为 N,表示不启用,配置为Y表示启用,所有名称都使用双引号包裹,例如:Id=>"Id"。